
并发程序难写,往往不在于接口多,而在于必须回答清楚三个问题:谁拥有数据,谁可以修改它,什么机制保证另一个线程安全地使用它? 本文围绕这三个问题梳理 C++ 并发与并行编程,代码以 C++20 标准库为核心,不使用第三方并发库。
这是系列的上篇,依次介绍执行模型、编译环境、线程生命周期与参数传递、共享状态与互斥锁、多锁与死锁、条件变量,以及 promise、packaged_task、async 等任务结果通道。下篇继续讨论原子变量与内存序、C++20 的取消与协调工具和工程实践,并实现一个完整的任务处理器。
文中标为“示例 N”的代码都是可以独立编译的完整程序,注释中的 @brief 说明用途,@param / @return 说明接口,@pre / @note / @warning 说明前提与并发边界;标为“片段”的代码只用于局部说明。
1. 先理解程序怎样同时推进
1.1 并发与并行
一个线程是一条执行指令的路径。一个进程可以包含多个线程:线程各有调用栈,但通常共享进程内的对象和地址空间。栈上的对象也可能通过引用被其他线程访问,“局部变量”不等于“线程私有”。
**并发(concurrency)**指多个活动在同一段时间内推进,可以交错执行,也可以同时执行。单核处理器也可以通过调度实现并发。**并行(parallelism)**指多个活动在同一时刻执行,通常需要多个执行资源。
例如,一名厨师轮流煮面和切菜是并发;两名厨师分别做这两件事可以是并行。并发主要帮助组织独立活动,并行主要帮助利用多个执行资源;两者经常一起出现,但不互相等同。
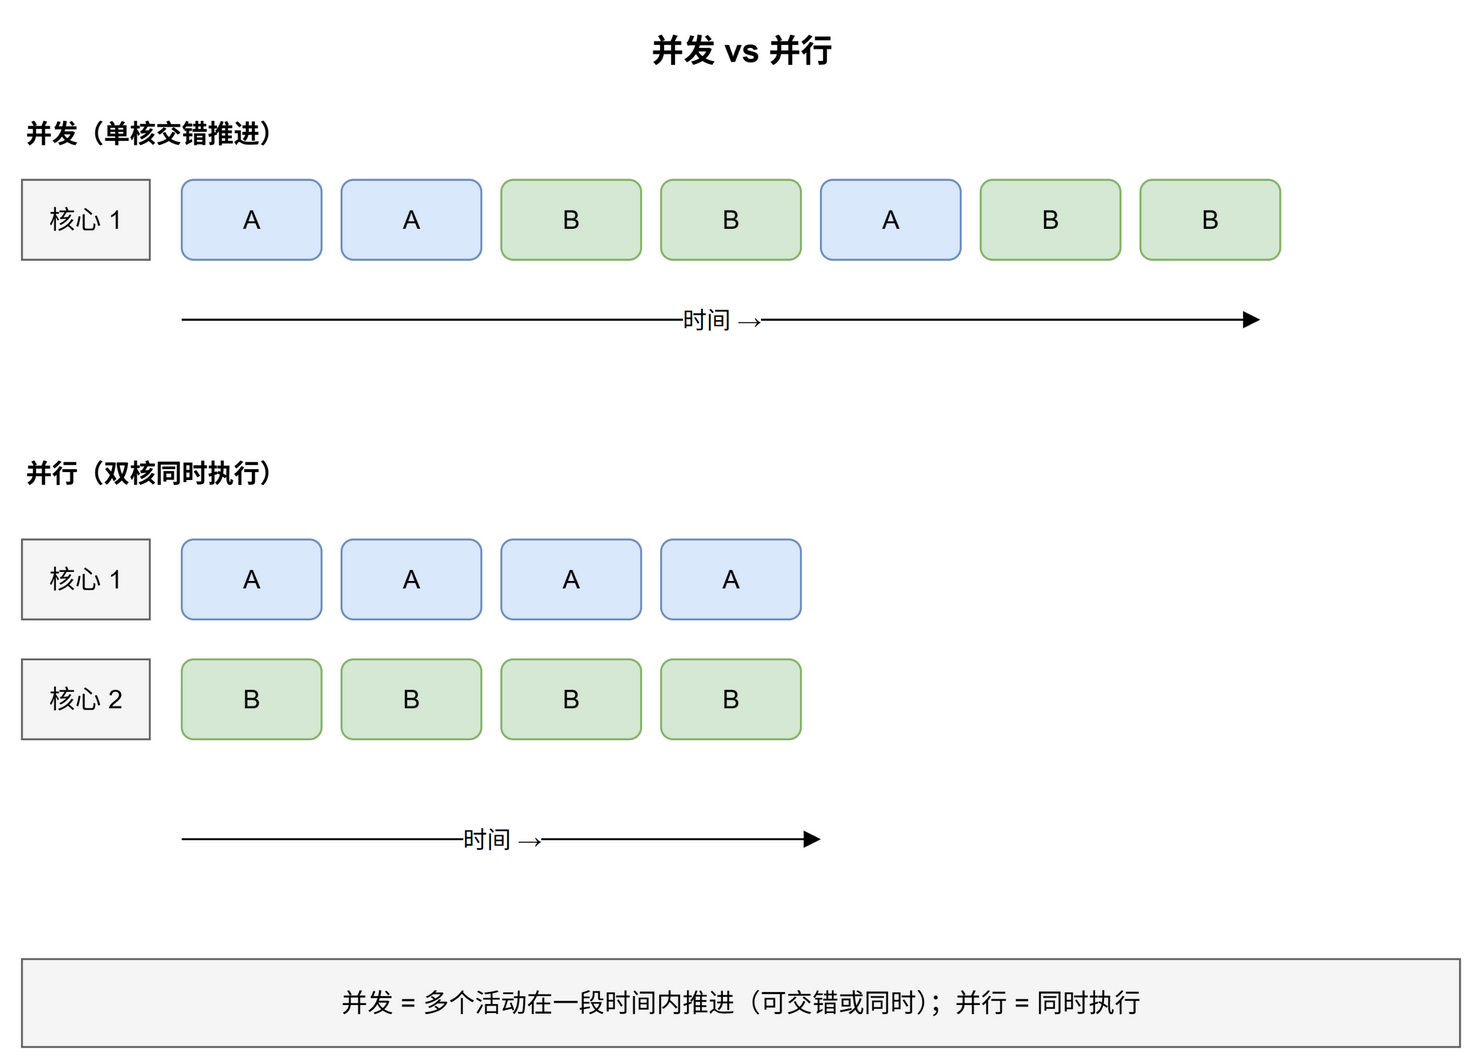
图 1-1:上半图示范单核上的并发交错,下半图示范双核并行;并发并不限于单核,多个并发活动也可以并行执行。
不能假设线程创建后立刻执行,也不能根据源代码中两个线程的排列顺序推断谁先完成。操作系统调度、编译器优化和硬件执行都会影响观察到的行为。
1.2 同步、异步、阻塞、非阻塞是其他维度
这些术语在不同领域略有差别,本文采用以下语境:
| 维度 | 要回答的问题 | 含义与例子 |
|---|---|---|
| 并发 / 并行 | 活动怎样推进? | 一段时间内共同推进 / 同一时刻执行 |
| 同步 / 异步 | 怎样取得操作的完成结果? | 调用流程直接得到完成结果 / 启动与取得结果分开 |
| 阻塞 / 非阻塞 | 尚不能完成时,当前调用是否等待? | 等待条件满足 / 立即报告当前状态或暂时无法完成 |
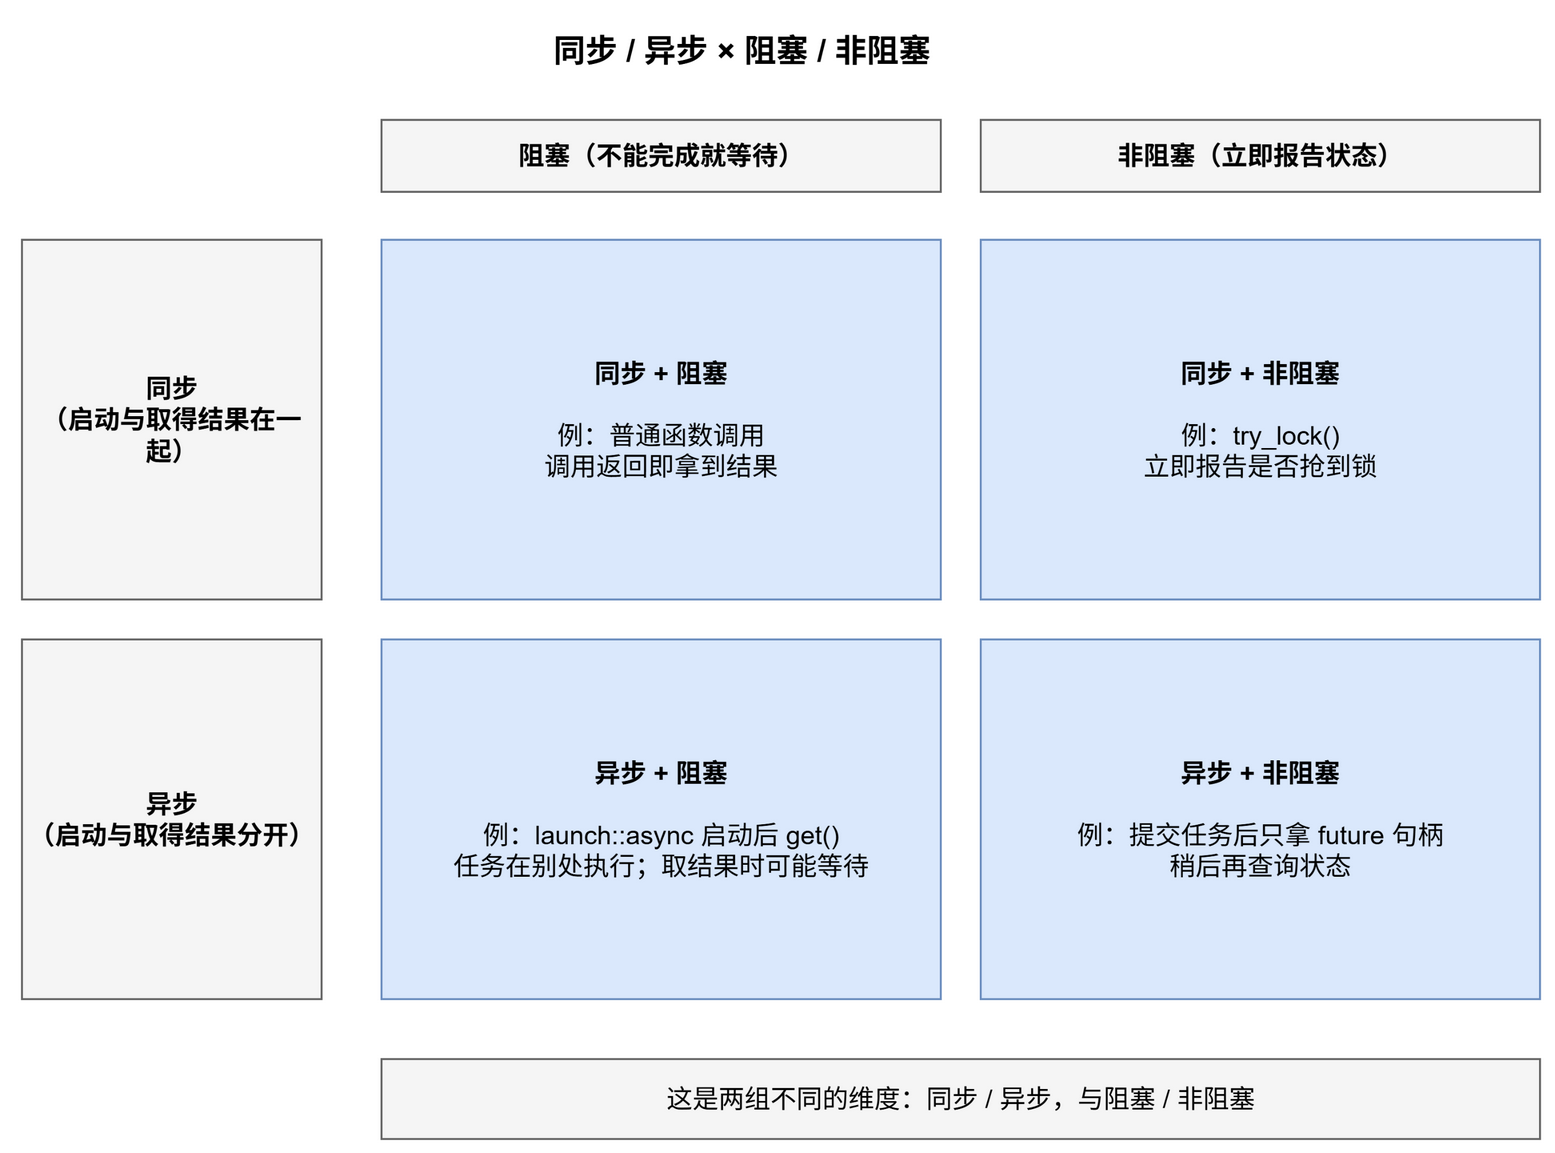
图 1-2:两组维度互相独立,可以自由组合;异步不代表非阻塞,同步也不代表一定等待。
发起异步任务可以很快返回一个结果句柄,但随后对句柄调用 get(),仍可能阻塞。同步的 try_lock() 直接报告本次尝试的结果,不等待锁变得可用。异步接口不必为每个任务创建新线程。还要注意:std::async 也支持 deferred(延迟执行)策略,但这种策略不会后台执行任务,而是在首次非定时等待时由等待线程执行(§7.4)。
还要区分“接口不阻塞”和算法理论中的进度保证:lock-free 大意是系统整体持续取得进展,wait-free 要求每次操作在有界步骤内完成。循环调用一个非阻塞接口,不会自动得到这些保证。
1.3 正确性包括安全性和活性
- 安全性:不越界、不访问已销毁对象、不破坏数据规则、不发生数据竞争。
- 活性:任务最终有机会完成,等待存在退出路径,不永久互相等待。
- 性能:在正确的前提下,延迟、吞吐量和资源消耗是否满足需求。
“跑了十次都正确”只观察了少量执行。并发程序必须依据同步规则说明为什么所有允许的交错都安全。
2. 编译环境与示例约定
2.1 编译命令逐项解释
把一个完整示例保存为 xxx.cpp,使用:
| |
| 部分 | 作用 |
|---|---|
g++ | GCC 的 C++ 编译驱动程序,会组织编译和链接,并通常自动链接 C++ 标准库 |
-std=c++20 | 选择 C++20 语言模式;不会给旧标准库补上尚未实现的功能 |
-O2 | 启用一组优化;优化不能修复错误程序,也可能让原先隐藏的问题显现 |
-Wall | 启用一组常用警告;名字中的 all 不表示所有警告 |
-Wextra | 再启用一些额外警告 |
-Wpedantic | 诊断选定语言标准要求诊断的一些问题及扩展用法;不是完整正确性证明 |
-pthread | 在支持的目标上配置线程相关的编译和链接选项 |
xxx.cpp | 输入源文件 |
-o xxx | 指定输出文件名 |
编译把源代码翻译为目标代码,链接把目标代码和所需库组合成可执行文件,运行才真正执行程序。上面的命令通常一次完成前两步,不会自动运行。只编译不链接可使用 -c;分开编译与链接时,线程选项应在相关阶段保持一致。
Linux/macOS 的终端运行方式:
| |
Windows 建议明确写出 .exe,在 PowerShell 中运行:
| |
-pthread 的支持和必要性取决于目标平台及工具链,不能把它机械替换成 -lpthread:前者可能还影响预处理和编译选项。某些平台已将线程功能集成到基础运行库,也不代表所有工具链都可以删去这个选项。macOS 上名为 g++ 的程序可能实际是 Apple Clang,应先看 g++ --version;MSVC 使用另一套命令选项。参见 GCC 链接选项中的线程说明。
2.2 工具链支持与示例约定
较旧的工具链对 C++20 并发库的支持并不完整。以 Windows 上的 g++.exe (tdm64-1) 10.3.0 为例(目标 x86_64-w64-mingw32,标准库日期宏 __GLIBCXX__=20210408):它提供 __cpp_lib_jthread=201911,但没有 semaphore、latch、barrier 和 atomic wait 的功能宏。下文提到的“旧工具链缺少功能”均指这类实现,不能据此推断 C++20 不提供这些接口;使用前应以功能测试宏实际探测。
GCC 官方状态表列出:jthread、stop_token 及可中断条件变量等待从 libstdc++ 10.1 提供;信号量、门闩、屏障和原子等待从 11.1 提供。这是实现版本信息,实际可用性仍受构建配置和平台影响。不能用“支持 C++20”推导“完整支持 C++20 标准库”。参见 libstdc++ C++20 实现状态。
文中标为“示例 N”的代码都是完整程序,可分别保存、分别编译,不要把多个 main() 放进同一个文件。明确写着“片段”的代码只用于局部说明,错误片段不应编译成正常程序运行。
本文的数值示例以 int 至少能表示 −2147483647 到 2147483647 的平台为前提;C++ 并不保证所有平台的 int 都有 32 位。若移植到更窄的整数平台,应先调整类型和输入范围。
示例使用固定输入和 assert 检查结果,默认命令没有定义 NDEBUG,因此断言生效。断言只用于表达示例的预期结果,不能代替实际应用中的输入检查和错误处理。
3. 线程的第一条规则:先管理生命周期
3.1 std::thread 启动执行,join() 收回执行
std::thread 构造成功后,新的执行线程调用指定函数。线程对象是执行线程的管理句柄:不能复制,可以移动。线程函数已经返回,不代表句柄已经不需要回收。
先看这个类的接口全貌,示例 1 再展示最小用法。
构造与启动。用于传入任务的常用构造函数采用一个模板形式(片段;f 与实参满足可调用要求):
| |
f 可以是普通函数、lambda、函数对象,也可以是成员函数指针——此时第一个实参是调用对象(对象副本、指针或 std::ref 包装)。无法启动新线程(如资源不足)时抛出 std::system_error;保存可调用对象和实参时,其复制或移动操作也可能抛出其他异常。这些异常发生在构造线程的调用方,构造未成功时不会留下需要调用方 join 的新线程。实参先按 §3.3 的规则复制或移动进内部存储,再以 INVOKE 方式调用 f。线程函数的返回值被直接丢弃:要把结果带回,需要使用引用参数(示例 1)、受保护的共享状态(§4)或 future 结果通道(§3.4 简介,§7 完整展开)。
其余构造形式:默认构造不关联任何线程;拷贝构造与拷贝赋值被删除(句柄唯一拥有);移动构造与移动赋值转移管理权,源对象不再关联线程(移动赋值还须注意目标是否已 joinable)。
主要成员函数与相关工具:
| 接口 | 作用 | 注意事项 |
|---|---|---|
join() | 阻塞至关联线程结束并回收它 | 要求 joinable;返回与线程完成之间建立同步(示例 1 依赖这一点) |
detach() | 解除句柄与线程的关联,线程独立运行 | 要求 joinable;句柄不再提供 join,完成与错误通道需另行设计,一般应避免(§3.3) |
joinable() | 句柄是否仍关联某个线程 | 不表示“正在运行”;完整状态规则见下文 |
get_id() | 返回关联线程的 std::thread::id | 无关联时返回默认构造的 id;id 可比较、可输出,用于日志与诊断 |
native_handle() | 返回平台原生线程句柄 | 供平台特定 API 使用;使用该接口的代码不再可移植 |
hardware_concurrency()(静态) | 提示实现可提供的硬件并发数量 | 只是提示,允许返回 0;不能当作精确核数,也不等于“应该创建的线程数”(下篇 §10.1) |
std::this_thread::get_id() | 返回当前线程的 id | 自由函数,在任意线程内调用 |
std::this_thread::sleep_for() / sleep_until() | 挂起当前线程一段时间 | 不建立任何同步关系,不能用来“修复”数据竞争(§4.1) |
std::this_thread::yield() | 提示让出本次执行机会 | 仅是调度提示,不保证发生切换,也不是同步手段 |
完整接口规定见 C++20 草案的 thread 类。
示例 1:值传递与显式引用传递。
| |
输出 49。主线程在 join() 之前不读取 result,且 result 一直存活。线程完成与成功的 join() 返回之间有同步关系,所以这里不需要额外的互斥锁。
参数为何需要 std::ref、它与 Lambda 引用捕获有什么区别,见 §3.3。
joinable() 表示句柄仍关联某个线程,不表示它“正在运行”。默认构造、被移走、成功 join() 或 detach() 后的对象不再 joinable。join() 和 detach() 都要求对象仍然 joinable;非 joinable 时调用会报告 std::system_error,不能重复回收或分离。join() 还不能等待当前线程自身。移动后源对象不再 joinable,目标接管原关联;对仍 joinable 的 std::thread 做移动赋值也会调用 std::terminate()。对同一个线程句柄的操作不自动互相同步,应由一个管理者负责。
生命周期红线
std::thread析构时如果仍然 joinable,会调用std::terminate()终止程序。这是标准规定的错误处理策略:避免隐式等待掩盖阻塞,也避免隐式分离放任引用对象寿命失控;必须在析构前明确处理关联。
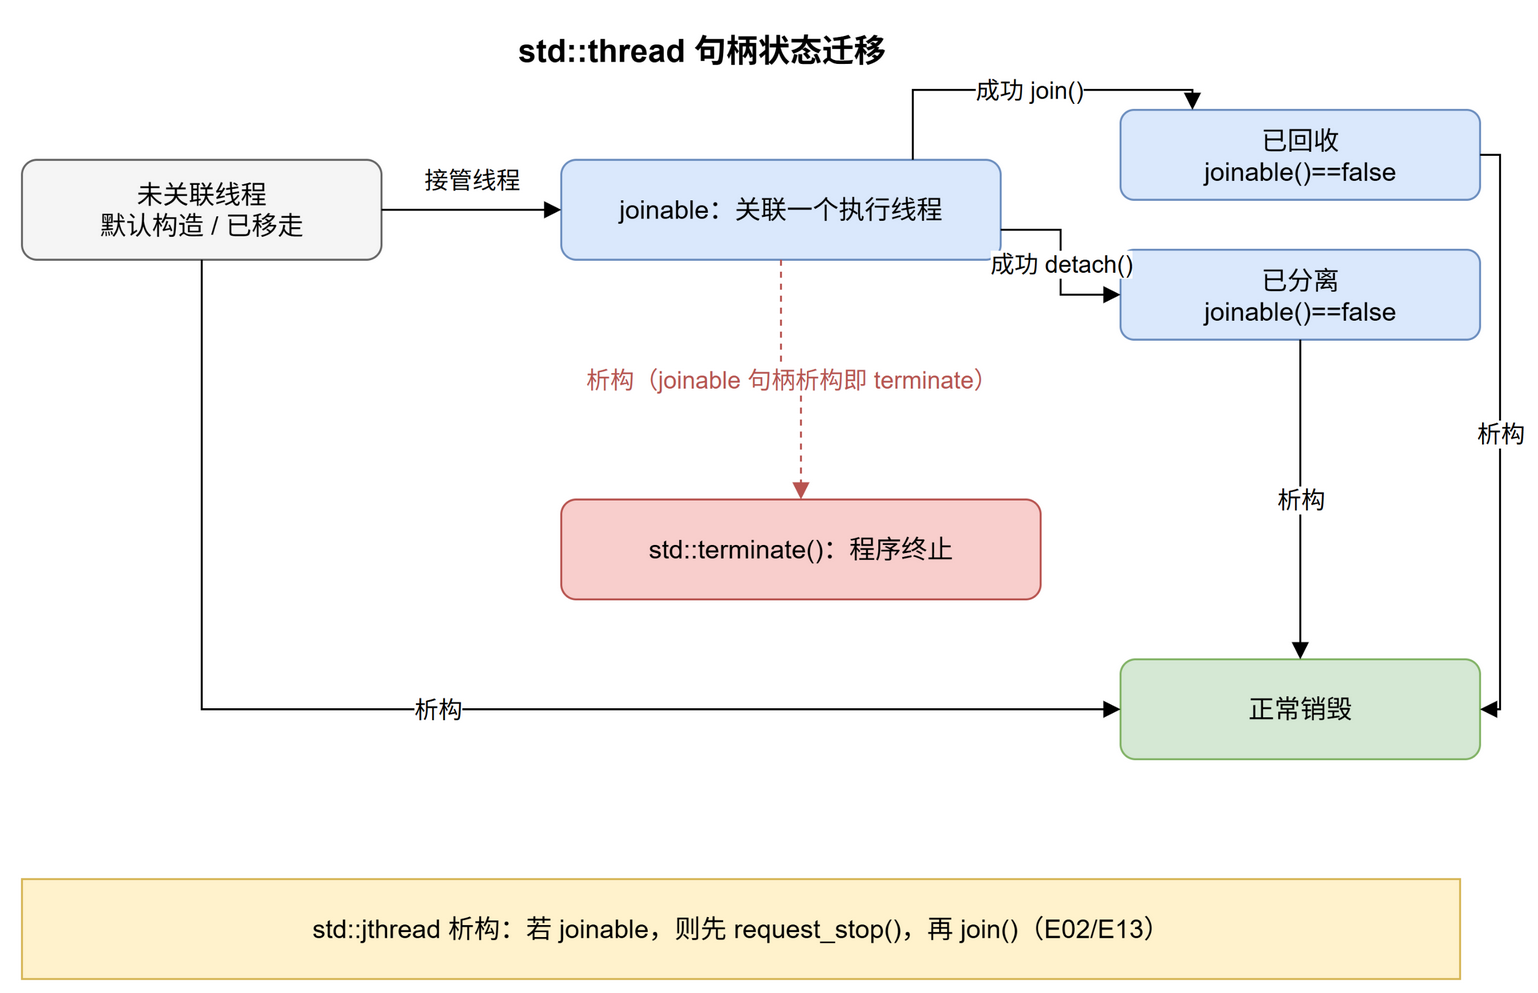
图 3-1:线程句柄的状态迁移;图中红线表示 joinable 对象直接析构的后果;这不是整个程序触发 std::terminate() 的唯一原因。
示例 1 中从成功构造到 join() 之间没有可能抛异常的业务操作;实际复杂代码优先使用 RAII。
3.2 RAII 与 std::jthread
RAII 的做法是把资源的释放绑定到对象析构:离开作用域,包括异常展开时,自动执行清理。锁守卫负责解锁,线程管理对象负责回收线程。
C++20 的 std::jthread 析构时,如果仍然 joinable,会先请求停止,再 join()。请求停止只是通知;线程是否响应取决于线程函数,下篇 §9.1 专门介绍。
与上文 std::thread 的联系和区别。严格说,它们是 <thread> 中的两个类,而不是同一个类的两个成员接口。两者都管理执行线程,都只能移动、不能复制;jthread 不是另一种调度模型,也不是 thread 的子类,二者不能直接相互转换。可以把 jthread 理解为提供了“自动回收 + 协作停止”的线程管理类,但不要据此假定它的具体内部实现。
| 对比项 | std::thread | std::jthread |
|---|---|---|
| 标准版本 | C++11 起 | C++20 起,还需标准库实现支持 |
| 析构时仍 joinable | 调用 std::terminate();必须事先处理线程关联 | 先 request_stop(),再 join();可能阻塞 |
| 停止机制 | 没有内置停止请求接口;需另行设计退出协议 | 内置停止状态与请求接口,线程仍须主动配合 |
| 显式等待 | join() 等待线程结束 | 同样支持 join(),且该调用本身不请求停止 |
| 移动赋值时目标仍 joinable | 调用 std::terminate() | 先请求旧线程停止并等待它结束,再接管新线程 |
以上行为可对照 C++20 草案的 thread 类与 jthread 类。
分别适用于什么情况?
- C++20 新代码通常优先考虑
jthread:线程由某个作用域或对象拥有,退出前需要回收,尤其是中途可能抛异常或提前返回的场景。不需要取消的有限任务也可以使用它,下面的示例 2 就没有接收停止令牌。 - 需要协作停止的长期工作线程适合
jthread:例如处理循环收到停止请求后清理并返回;但计算和等待路径都必须设计退出方式,详见下篇 §9.1。 - 兼容 C++11/14/17、旧库接口要求
std::thread,或已有完整线程管理封装时,可使用thread:应由现有封装或 RAII 守卫覆盖正常与异常路径,而不是只在函数末尾写一次join()。C++20 中也能把独立的stop_source/stop_token配合thread使用,协作停止并非jthread专属。
自动回收不等于自动解决并发问题
jthread不能强制终止线程;工作若永久等待或不退出,析构也可能永久等待。不要持有工作线程需要的锁去等待它。需要明确等待时机时,仍可提前显式join(),不必因此改用thread。两者都支持detach(),但分离后不再由该对象自动回收,不能把分离当作避免阻塞的通用办法。jthread也不会自动保护共享数据、延长被引用对象的寿命或转送线程异常。
jthread 的接口一览。它的启动时机、实参传递和 joinable 状态规则与 std::thread 相同(§3.1、§3.3),差异集中在自动回收与协作停止:
| 接口 | 作用 | 注意事项 |
|---|---|---|
| 构造函数 | 与 std::thread 一样地启动线程;若 f(token, args...) 可调用,优先自动注入停止令牌,否则调用 f(args...) | 函数不接受 token 也能构造;是否响应停止取决于它是否通过参数、捕获等方式观察停止状态 |
request_stop() | 向关联的停止状态发出一次停止请求 | 只是通知;返回不代表线程已经退出 |
get_stop_token() | 取得观察停止状态的 token | 通常由 jthread 自动注入,很少需要手动取 |
get_stop_source() | 取得可发出请求的 stop_source | 可把请求能力转交给其他管理者 |
join() / detach() / joinable() / get_id() | 与 std::thread 相同 | join() 不自动请求停止,回收与停止是两件独立的事 |
析构时的“先请求停止、再 join”正是 request_stop() 与 join() 的组合。停止机制本身在下篇 §9.1 专门介绍;接口规定见 C++20 草案的 jthread 类。
示例 2:自动回收与跨线程传递异常。
| |
输出 worker failed。这里只有一个线程写入 error,主线程在回收后读取,因此不需要用锁保护它。catch (...) 在此有明确目的:将任意工作异常交给调用者处理,并非静默忽略。
线程入口函数中未捕获的异常会导致 std::terminate();在创建线程的代码外面加 try/catch,只能捕获创建时的失败,捕获不到另一个线程执行时抛出的异常。jthread 不会自动转送异常。后面的 future 能更自然地承担结果与异常通道。
3.3 参数、捕获与所有权
构造线程时,普通参数会按 std::decay 后的类型(去掉引用与顶层 cv 修饰,数组和函数名退化为指针)复制或移动到内部存储,再用于调用函数。std::ref(x) 不复制 x,也不延长 x 的寿命;std::cref(x) 是对应的 const 引用包装,适合线程只读共享数据的场景。
3.3.1 普通参数与引用包装器
示例 1 的 calculate 是普通函数:参数列表决定它接收什么;std::thread 决定这些实参怎样先保存、再交给函数。std::ref / std::cref 只改变传参语义,不提供加锁或自动续命。
为什么这里必须写
std::ref(result)?std::thread构造时会先把实参复制或移动到自己的内部存储,保存的是去掉引用修饰后的类型(§3.3)。如果直接写result,内部存下的就是一份int副本;调用calculate时会以右值形式传递它,不能绑定到函数要求的int&形参,线程构造在编译期就会失败。
std::ref(result)不复制result,而是把它包装成std::reference_wrapper<int>:包装器本身可以安全地复制进内部存储,调用线程函数时又能隐式转换回int&,于是线程函数拿到的仍是指向主线程那个result的引用。也就是说,std::ref解决的是“实参必须先复制进存储”与“函数要求按引用接收”之间的矛盾;它既不转移所有权,也不延长result的寿命,对象存活仍由调用方负责。构造规则见 C++20 草案的 thread 构造函数。
std::reference_wrapper<T> 常用的两个引用访问方式是:成员函数 get() 显式返回 T&;隐式转换运算符 operator T& 让它能直接用在需要 T& 的地方。std::ref(t) 保留原对象的 const 属性:普通 T 对象得到 reference_wrapper<T>,const 对象得到 reference_wrapper<const T>。std::cref(t) 提供 const 引用访问,选择原则和平时选 T& 还是 const T& 形参一致。
正确片段(函数体内;take(int&) 已声明并定义,已包含 <functional>):
| |
除了线程传参,包装器的另两类典型用途:std::bind / 按值捕获时需要引用语义(std::bind(f, std::ref(x)));在容器中存放“引用”(std::vector<std::reference_wrapper<int>>),绕过引用不能作为容器元素的限制。两点约束:包装器不拥有对象,原对象先销毁后再 get() 即为悬垂引用;包装临时量的重载被 =delete,std::ref(42) 无法编译,防止包装立即销毁的对象。
3.3.2 Lambda:捕获是保存环境,参数是调用时输入
Lambda 表达式会创建一个闭包对象,可以理解为“带着所需数据的可调用对象”。写法为 [捕获列表](参数列表) mutable -> 返回类型 { 函数体 };mutable 和返回类型按需省略。捕获在创建闭包时发生,形参在调用闭包时取得;闭包再按普通可调用对象的规则复制或移动进线程。
| 写法 | 保存什么 | 并发时要证明什么 |
|---|---|---|
[] | 不捕获外部局部变量;仍可用形参、全局对象等 | 不捕获不等于线程安全,全局共享状态仍需同步 |
[x] | 创建闭包时的 x 副本 | 后续修改原 x 不改变这份副本;复制动作本身也不能与写 x 冲突 |
[&x] | 对原 x 的引用 | 对象活到最后一次访问;并发冲突访问另需同步 |
[=] / [&] | 对需要隐式捕获的局部变量默认按值 / 按引用捕获 | 不会无条件捕获作用域中所有变量;线程入口优先显式列出依赖 |
[x, &result] | 输入快照与输出引用 | 输入独立;结果在 join 后读取,不把引用当成锁 |
[p = std::move(p)] | 初始化捕获,将资源移入闭包(C++14 起) | 原所有者不再使用已移走的资源;闭包用 std::move 移入线程 |
[this] | 当前对象的指针 | 不拥有当前对象;对象不能在线程使用期间销毁 |
[*this] | 当前对象的副本(C++17 起) | 类型必须可复制;指针等成员仍按各自的复制语义处理 |
默认情况下,闭包的调用运算符是 const,所以不能直接修改按值捕获的普通副本;加 mutable 后可以修改该副本,不会因此修改原变量。引用捕获仍可以修改原对象,无需为此添加 mutable。同一个可变闭包若被多个线程共享调用,仍可能发生数据竞争;mutable 不是同步机制。
示例 3:把示例 1 的平方计算改成 Lambda,分别演示输入快照、可变副本、引用写回与独占资源转移。
| |
输出 49 64 81 81。[input, &result] 与示例 1 的 calculate(input, std::ref(result)) 表达同一种数据安排:输入独立保存,输出引用调用者对象,join 后读取。改成 [](int value) { return value * value; } 则是在调用时接收输入;把它交给 std::thread 仍会丢弃返回值,§3.4 将用 async 接收返回值。
  flowchart TB
    Source["创建闭包时的局部对象 x"]
    Source -->|"[x]:复制"| Copy["闭包拥有自己的 x 副本"]
    Source -->|"[&x]:引用"| Borrow["闭包访问原对象;不延长寿命"]
    Owner["独占资源 p"] -->|"[p = std::move(p)]"| Move["闭包接管资源所有权"]
    Copy --> Thread["闭包复制或移动进线程"]
    Borrow --> Thread
    Move --> Thread
    Thread --> Join["先回收线程,再销毁被引用对象"]
    classDef owned fill:#e8f2fc,stroke:#4682b4,color:#182c42
    classDef borrowed fill:#fff4dc,stroke:#b8860b,color:#463611
    class Copy,Move owned
    class Borrow borrowed
图 3-2:捕获方式决定闭包保存什么;线程回收与访问同步仍须单独设计。
3.3.3 成员捕获与对象寿命
在成员函数中,[=] 若隐式捕获 this,保存的仍然是指针,不是整个对象;这种隐式写法在 C++20 中已弃用。[this]、[&] 也不会给对象续命。优先捕获任务实际需要的成员副本,例如 [value = value_];确实需要对象快照且类型可复制时,才使用 [*this]。裸指针、string_view、span 和引用包装器即使按值捕获,也仍然不拥有它们引用的数据。
正确片段(已包含 <thread>;演示标量成员的快照,不涉及共享修改):
| |
捕获规则见 C++20 Lambda 捕获规定。§7.2 的示例 11 会把同一种移动捕获用于 promise:捕获方式既决定可调用性,也决定谁负责交付结果。
3.3.4 分离线程不能替代生命周期管理
错误示例,请勿照搬(片段;假设已包含相关头文件):
| |
detach() 解除管理句柄和执行线程的关联,既不等待完成,也不延长引用对象的寿命。如果线程在函数返回后访问 local,就是访问已结束生命周期的对象,属于未定义行为;恰好提前执行完时可能看起来正常。
修复是像示例 2 一样用内层 jthread 作用域保证先等待、后销毁数据,或真正转移任务需要的数据所有权。即使改成值捕获解决了悬空引用,分离任务的退出、错误处理、程序关闭问题仍然存在,因此应避免裸 detach()。
声明顺序也很重要:局部对象按构造顺序的逆序销毁。共享数据、互斥锁、条件变量应先构造,引用它们的线程后构造。自动回收不能解决死锁;析构时持锁等待一个需要这把锁的线程,同样会卡住。 C++20 草案的 jthread 规定 给出了停止请求与回收的顺序。
3.4 用 async/future 取回线程的返回值
§3.1 已经说明,线程函数的返回值被直接丢弃;示例 1 的对策是主线程备好结果变量,再用 std::ref 把它的引用传给线程函数,由工作线程“写回来”。还有一条更直接的路:不写回变量,而是让任务把返回值存进一个双方都能看到的结果通道。C++20 草案的 async 规定 中 std::async 负责启动任务并自动接好这条通道,std::future 是通道在调用方一侧的“提货单”。这套机制的完整形态(共享状态、promise、packaged_task、shared_future 与析构规则)在 §7 展开,本节先给出足以覆盖“算个值回来”这一常见需求的组合。
核心是三个动作:显式传 std::launch::async 启动任务,保存返回的 future,最后用 get() 等待并取回值或异常。启动任务不保证 CPU 同时执行它们,也不保证它立即获得调度。
  sequenceDiagram
    participant Main as 主线程
    participant Worker as 异步任务
    participant State as 共享状态
    Main->>Worker: async(launch::async, square, 7)
    Note over Main: 保存 future,继续独立工作
    Worker->>State: 存入 49 或异常,标记就绪
    Main->>State: future.get(),必要时等待
    State-->>Main: 取回值或重新抛出异常
    Note over Main: get 后此 future 不再关联状态
图 3-3:启动与取结果分开;任务可能在 get 前或 get 等待期间完成,图中只画其中一种时序。
示例 4:用 async 与 future 取回返回值与异常。
| |
输出 task launched; main thread free、49、no square for negative input 三行,全部由主线程写出,顺序与线程调度无关。与示例 1 对照:计算目标与示例 1 相同,但无需预先提供共享输出变量、std::ref 或显式 join()——“算个值回主线程”被压缩成一行 std::async 加一行 get()。
先保存句柄,再取回结果 普通 future 的
get()只能消费一次;valid()只说明有关联状态,不说明任务已经完成。不要丢弃 async 返回的临时句柄,它的析构可能隐含等待。完整接口见 §7.1,执行策略和析构规则见 §7.4–§7.5。
如果任务只是算一个结果,先用本节的 async;如果需要长期工作线程、显式交付时机或队列调度,再使用 §7 的 promise / packaged_task 和下篇 §11 的任务处理器。async 不是 C++20 的通用线程池接口。
4. 共享可变状态为何危险
4.1 data race 与 race condition
**数据竞争(data race)**是 C++ 内存模型中的错误:不同线程对同一内存位置存在冲突访问,至少一个不是原子操作,又没有必要的 happens-before 顺序。常见情形是一个写、另一个读或写普通对象。数据竞争导致未定义行为。
**竞态条件(race condition)**是更广的逻辑问题:结果是否正确取决于事件的交错。即使每次访问都使用原子或锁,没有数据竞争,也可能出现逻辑竞态。
错误示例,请勿照搬(片段;count 为普通整数,初值 0):
| |
++count 涉及读、计算、写,不能因为只有一行就认为不可分割。两线程可能都读取 0,再各写回 1;但“丢一次更新”只是帮助理解,未定义行为并不限于得到 1 或 2。优化器可以依据没有数据竞争的前提优化程序。
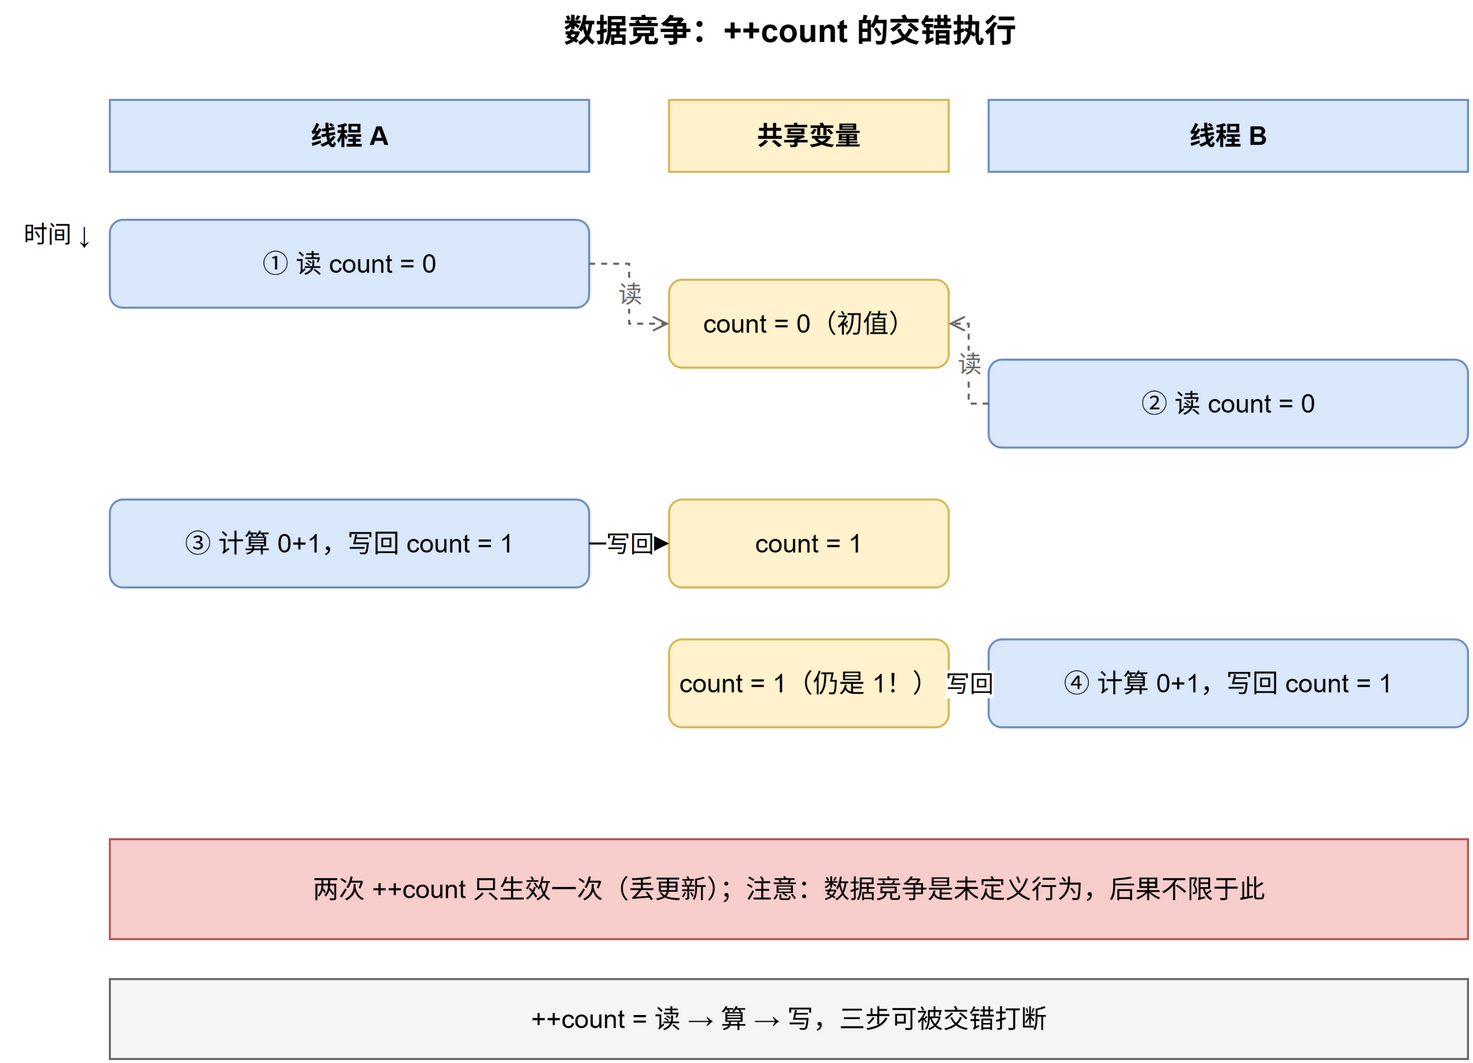
图 4-1:两个线程的 ++count 交错执行,两次自增只生效一次;注意数据竞争是未定义行为,“丢更新"只是其中一种可能后果。
volatile 不提供线程间的互斥或同步,不能修复这个问题。增加 sleep_for() 也不能建立同步关系。修复需要原子读改写,或将完整操作放进同一把锁保护的临界区。
另一种逻辑竞态:账户余额的查询和扣减分别加锁,两个线程都查询到“余额足够”,随后都扣减。每个单独方法可能没有数据竞争,但“检查并扣减”不是一个整体。应把整个业务规则放在一个临界区内。数据竞争定义可核对 C++20 草案的冲突访问与 happens-before。
4.2 mutex 同时提供互斥和同步
互斥锁 std::mutex 不会给某个变量自动贴上保护标签;程序员必须约定哪些数据由哪把锁保护,并让所有相关访问遵守约定。
它的两个作用:
- 互斥:同一时刻只有一个线程持有这把锁,从而让整个临界区不与另一个受保护临界区交错。
- 同步:一次解锁与之后取得这把锁的加锁操作建立同步,使先前临界区的写入能够被后续临界区安全观察。
与加锁直接相关的成员函数是三个:lock() 阻塞直至取得锁,try_lock() 尝试一次并立即报告成功与否,unlock() 释放锁且必须由持有线程执行;另有 native_handle() 返回平台原生句柄,供平台特定 API 使用,代价与 §3.1 的同名接口一样是失去可移植性。业务代码不应直接调用这些加锁成员:手工配对容易在异常或提前返回时漏掉 unlock()。这些成员是锁管理对象(§4.3)的底层接口,日常代码通过 RAII 守卫间接使用。std::mutex 默认构造即处于未持有状态,不可复制也不可移动。规定见 C++20 草案的 mutex 类。
示例 5:保护共享计数器。
| |
输出 20000。若主线程要在线程运行期间查看 count,也必须加同一把锁。仅锁写、不锁读,或者每个线程用自己的锁,都没有建立所需保护。
这个示例故意每次加锁以展示语义;真实统计更适合各线程先累计到局部变量,再合并,后面讨论原因。标准同步规定见 mutex requirements。
4.3 选择锁管理对象
| 类型 | 适合场景 | 注意事项 |
|---|---|---|
lock_guard | 进入作用域加锁,退出解锁 | 简单、开销小,不提供手动解锁 |
unique_lock | 条件变量等待、延迟加锁、需要提前解锁 | 可移动,会记录是否拥有锁;复杂能力按需使用 |
scoped_lock | 同时取得多把互斥锁 | C++17 起提供;多锁时采用避免死锁的加锁算法 |
shared_lock | 配合 shared_mutex 取得共享(读)锁 | C++14 起提供;与 unique_lock 类似的灵活管理能力 |
不要写一个没有名字的临时锁守卫,临时对象会在语句末尾销毁。临界区尽量短,但不能把必须原子完成的业务过程拆开。不要在持锁时执行未知回调、慢 I/O、等待其他任务等不可控操作。
std::mutex 是非递归独占锁:同一线程不能重复加锁,解锁必须由持有者执行。std::lock_guard、std::scoped_lock 不可复制也不可移动;std::unique_lock 和 std::shared_lock 可移动、不可复制,移动转交的是锁所有权管理责任,不延长底层锁的寿命。移动守卫不改变底层互斥锁的持有线程:对于标准互斥锁,不能把已持锁的守卫交给另一线程解锁或析构;共享锁同样要由取得该共享所有权的线程释放。
下面逐个说明四种守卫的作用、常用构造形式、成员接口与典型场景。底层 mutex 决定加锁规则,守卫负责何时调用加锁与解锁接口;先区分这两层,再看构造标签。
4.3.1 加锁策略标签
加锁策略标签。 守卫的构造函数可接受下列标签来改变构造时的加锁行为(均定义在 <mutex>,类型分别为 defer_lock_t 等,标签本体是对应的常量对象):
| 标签 | 构造时的行为 | 可用于 | 前置条件 / 结果判定 |
|---|---|---|---|
std::defer_lock | 只关联,不加锁 | unique_lock、shared_lock | 无;之后用成员 lock() 或 std::lock 取得 |
std::try_to_lock | 尝试加锁一次,失败不阻塞 | unique_lock、shared_lock | 须满足底层尝试加锁的前置条件;用 owns_lock() 判定是否取得 |
std::adopt_lock | 不加锁,直接接管 | 四种都支持 | 当前线程必须已按守卫对应的模式持有传入的锁;shared_lock 要求共享模式,否则未定义行为 |
lock_guard 只接受 adopt_lock(它不存在“关联了但没锁”的中间状态);scoped_lock 只接受 adopt_lock(多锁的正常获取已由它内部算法负责)。
4.3.2 lock_guard:作用域内独占
std::lock_guard<Mutex>:最简独占守卫。 作用是“进入作用域加锁、离开作用域解锁”,此外没有任何能力:没有成员函数可供操作,连访问底层锁的 mutex() 都不提供。它提供简单的 lock()/unlock() 配对;标准不承诺具体对象大小或零开销。
| 接口 | 作用 | 注意事项 |
|---|---|---|
explicit lock_guard(Mutex& m) | 构造并调用 m.lock() | 阻塞直至取得锁 |
lock_guard(Mutex& m, std::adopt_lock_t) | 接管已持有的锁 | 当前线程须已持有 m |
~lock_guard() | 调用 m.unlock() | 唯一的解锁途径;异常路径同样生效 |
| 复制构造 / 移动构造及对应赋值 | 复制被删除,不提供可用的移动操作 | 锁所有权不可转移 |
正确片段(函数定义,已包含 <mutex>;m 与 shared_data 的寿命覆盖调用期,调用方尚未持有 m):
| |
典型场景:一把独占锁 + 临界区恰好是一个作用域,这是大多数加锁代码的形态。需要延迟、尝试、限时、提前解锁等任何灵活性时,换 unique_lock。
4.3.3 unique_lock:灵活控制独占锁
std::unique_lock<Mutex>:功能完整的独占锁管理器。 相比 lock_guard 多记录一个“是否持有锁”的状态位,由此支持延迟加锁、尝试加锁、限时加锁、提前解锁、重新加锁、释放管理权和移动转交。std::condition_variable::wait() 只接受它(§6.1),因为等待期间必须临时释放并重新取得锁。完整接口:
| 接口 | 作用 | 注意事项 |
|---|---|---|
unique_lock() | 不关联任何锁的空守卫 | 之后可由移动赋值接管 |
explicit unique_lock(Mutex& m) | 构造并 m.lock() | 阻塞直至取得 |
unique_lock(m, defer_lock_t) | 只关联不加锁 | 配 std::lock(示例 7)或稍后 lock() |
unique_lock(m, try_to_lock_t) | 构造时尝试一次 | 用 owns_lock() 判定结果 |
unique_lock(m, adopt_lock_t) | 接管已持有的锁 | 调用前当前线程须已持有 m |
unique_lock(m, 时长) / unique_lock(m, 时间点) | 限时尝试加锁 | 要求锁满足 TimedLockable,如 std::timed_mutex |
lock() / try_lock() | 加锁 / 尝试一次 | 守卫须已关联 mutex 且未持锁;未关联或已持锁会抛 std::system_error,底层锁的前置条件也须满足 |
try_lock_for() / try_lock_until() | 限时尝试加锁 | 同上;返回是否取得 |
unlock() | 提前解锁 | 要求当前持有;之后可再 lock(),业务前提需重查 |
release() | 解除关联并返回 Mutex*,不解锁 | 解锁义务转给调用方;误用即永久占锁 |
owns_lock() / operator bool() | 是否持有锁 | 查询内部状态位 |
mutex() | 返回关联的 Mutex* | 未关联时返回 nullptr |
swap() | 与另一个同类型守卫交换状态 | — |
| 移动构造 / 移动赋值 | 转交锁管理责任 | 复制被删除;不延长底层锁的寿命 |
正确片段(函数定义,已包含 <chrono>、<mutex>;选用 timed_mutex 以演示限时尝试):
| |
移动语义使 unique_lock 可以从函数返回“已加好的锁”,在同一线程内把锁管理责任交给调用者;release() 则只是放弃管理并返回底层锁的指针,不会解锁——这是 lock_guard 做不到的一类设计。代价是需要维护锁拥有状态,使用规则更复杂;实际开销取决于实现与优化,错误使用(如对未持有的守卫 unlock())会在运行时抛 std::system_error 而不是编译期拦住。
4.3.4 互斥锁家族与限时尝试
互斥锁家族与 std::timed_mutex。 上面的 unique_lock_demo 选用了 std::timed_mutex,这里把它讲清楚。标准库提供一组互斥锁类型,差别只在“独占还是共享”“能否递归加锁”“是否支持限时尝试”三个维度:
| 类型 | 头文件 | 能力 | 与 std::mutex 的差异 |
|---|---|---|---|
std::mutex | <mutex> | BasicLockable + Lockable | 基准:独占、非递归、无限时 |
std::timed_mutex | <mutex> | 再满足 TimedLockable | 增加限时尝试成员(下表) |
std::recursive_mutex | <mutex> | BasicLockable + Lockable | 允许同一线程重复加锁(配同等次数解锁) |
std::recursive_timed_mutex | <mutex> | 再满足 TimedLockable | 递归 + 限时 |
std::shared_mutex | <shared_mutex>,C++17 | 独占与共享加锁能力 | 增加共享(读)模式,见 §4.3.6 的示例 |
std::shared_timed_mutex | <shared_mutex>,C++14 | Shared + Timed | 共享模式也支持限时尝试 |
std::timed_mutex 的接口 = std::mutex 的三个加解锁成员加两个限时成员:
| 接口 | 作用 | 注意事项 |
|---|---|---|
lock() / try_lock() / unlock() | 与 std::mutex 相同 | 非递归:同一线程重复 lock() 是未定义行为 |
try_lock_for(duration) | 在相对超时预算内尝试,取得才返回 true | 允许伪失败(即使锁空闲也可能返回 false);超时后返回 false;实际返回允许有延迟 |
try_lock_until(time_point) | 尝试到绝对时间点为止 | 时钟类型由模板参数给出;系统时钟被调整会影响等待上限 |
native_handle() | 平台原生句柄 | 失去可移植性(§4.2) |
语义要点:标准建议实现用稳定时钟计量 try_lock_for 的相对超时,但这不是必须满足的实现要求,try_lock_until 用调用者指定的时钟;超时预算不是实时返回的硬上限——被调度器耽搁时返回可能更晚,锁的获取本身也没有公平性承诺。与守卫的配合关系:lock_guard 没有限时接口,配 timed_mutex 也只能普通加锁;限时能力经由 unique_lock 的限时构造与 try_lock_for()/try_lock_until() 成员转发(unique_lock_demo 正是这条路径)。不要把超时当作死锁的修复手段:超时给调用方提供放弃等待的路径,拿到 false 后业务仍要有放弃或重试的设计;顺序错误的多锁获取即使各自限时,也可能反复超时形成活锁(§5.5)。
正确片段(函数定义,已包含 <chrono>、<mutex>;m 与数据的寿命覆盖调用期,调用方尚未持有 m):
| |
典型场景:等待超过业务预算后允许放弃,或在超时后记录诊断信息。它不能承诺界面绝不卡顿,也不能保证周期任务按硬截止时间返回。普通后台代码默认 std::mutex 即可,确有超时需求再升级到 timed_mutex——实际成本取决于实现与负载,不应预设定时锁一定使用轮询或一定更慢。规定见 C++20 草案的定时锁要求。
4.3.5 scoped_lock:统一管理多把锁
std::scoped_lock<Mutex...>:一次取得零把、一把或多把锁(C++17)。 多把锁以避免死锁的算法统一获取(与 std::lock 同源,见示例 7/示例 9);恰一把时等价于 lock_guard;零把时不做任何事。接口只有构造与析构,没有 defer/try/unlock——它刻意不提供灵活性,适合不需要中途解锁的多锁作用域。
| 接口 | 作用 | 注意事项 |
|---|---|---|
explicit scoped_lock(Mutex&... m) | 取得全部锁;多把走避免死锁算法 | 阻塞直至全部取得 |
scoped_lock(std::adopt_lock_t, Mutex&... m) | 接管全部已持有的锁 | 每把都须已被当前线程持有 |
~scoped_lock() | 释放全部锁 | 对所有关联锁调用 unlock;标准不规定释放顺序 |
| 复制构造 / 移动构造及对应赋值 | 复制被删除,不提供可用的移动操作 | 多锁所有权不可转移 |
正确片段(函数定义,已包含 <mutex>;a、b 是两把不同的 mutex,调用方未持有它们):
| |
典型场景:必须同时持有多把独占锁(转账、快照、双缓冲区交换)。新项目优先于 unique_lock + std::lock 的手动组合;只有还需要延迟加锁、提前解锁或配合条件变量时,才退回 unique_lock 形态。
4.3.6 shared_lock:共享读取与独占更新
std::shared_lock<SharedMutex>:共享(读)锁管理器(C++14)。 配合 std::shared_mutex / std::shared_timed_mutex 使用:多个读者的 shared_lock 可同时持有,与写者的独占锁互斥。接口与 unique_lock 大体对应,关键差异是所有加解锁操作走底层锁的 lock_shared()/unlock_shared() 等共享模式成员;独占(写)锁仍用 unique_lock 取得,下文的 read_settings/write_settings 片段正是这对组合。
| 接口 | 作用 | 注意事项 |
|---|---|---|
| 构造形式 | 与 unique_lock 类似:空构造、直接、defer、try_to、adopt、限时及移动构造 | 限时重载要求底层类型支持共享限时加锁,如 shared_timed_mutex |
lock() / try_lock() | 共享模式加锁 / 尝试一次 | 底层走 lock_shared() / try_lock_shared() |
try_lock_for() / try_lock_until() | 共享模式限时尝试 | 底层走 try_lock_shared_for() 等 |
unlock() / release() | 提前释放 / 放弃管理且不解锁 | 语义同 unique_lock |
owns_lock() / operator bool() / mutex() / swap() | 状态查询与访问器 | 语义同 unique_lock |
| 移动构造 / 移动赋值 | 转交共享锁管理责任 | 复制被删除 |
std::shared_mutex 支持共享与独占两种模式:多个读者可同时持共享锁;写者持独占锁时排斥全部其他读者和写者。共享模式允许多个持锁者同时进入,本身不互斥;本例约定共享锁内只读共同配置,更新使用独占锁。读锁仍有成本,不保证更快,也不保证公平;先用普通 mutex,测出瓶颈后再评估。
正确片段(已包含 <mutex>、<shared_mutex>;可由多个线程调用):
| |
std::shared_mutex 没有原子“读锁升级为写锁”的标准接口;先释放读锁再取得写锁后,需要重新检查此前读到的状态。
如何选择(决策路径):一把独占锁、临界区即作用域 → lock_guard;需要延迟/尝试/限时/提前解锁、配合条件变量、或从函数返回锁 → unique_lock;同时持多把独占锁 → scoped_lock;shared_mutex 的读者 → shared_lock,写者 → unique_lock。底层锁所需的能力按用法区分:独占能力是 BasicLockable(lock/unlock)→ Lockable(增加 try_lock)→ TimedLockable(增加限时尝试);共享模式另有对应的 lock_shared / try_lock_shared 及限时要求,并非这条链的最后一级;守卫只是把这些要求转发给底层锁的模板参数,不满足时在实例化处编译失败。规定见 C++20 草案的锁管理要求。
多锁的完整获取过程与示例 7 见 §5.2;账户支付的业务不变量与示例 8 见 §5.3。
4.4 一次性初始化:std::call_once
有些数据只需要在首次使用时初始化,例如一份全局配置。直觉上可能会写成“先检查,再初始化”,但多个线程可能同时通过检查,造成重复初始化;普通变量上的并发读写还会形成数据竞争。手工的双重检查锁定也不容易写对:即使一个线程看到“已初始化”,没有正确的原子操作和内存序,也不能保证它能看到完整的初始化结果。
使用 std::call_once 时,需要提供一个 std::once_flag 和一个初始化函数。对于同一个 flag,标准库保证:
- 多个线程同时调用时,一个线程执行初始化函数,其他线程等待;
- 初始化函数正常返回后,flag 被标记为完成,之后的调用不再执行初始化;
- 其他正常返回的调用与这次初始化建立同步,因此可以安全读取已经发布的结果。
这里的“一次”指一次成功完成的初始化,不是“初始化函数只能进入一次”。如果初始化抛出异常:
- 异常会传给实际执行初始化函数的调用者;
- flag 不会被标记为完成,等待中的其他调用或后续调用可以重试;
- 失败前已经产生的副作用不会自动撤销,重试时必须考虑这一点。
正确片段(假设已包含 <mutex> 等头文件,Config 与 load_defaults() 已定义):
| |
call_once 只负责发布初始化结果;如果 config 之后还会被修改,后续读写仍需另行同步。
异常重试依赖目标工具链的实现 按 C++ 标准,初始化抛异常后,后续调用可以重试。但在 TDM-GCC 10.3.0 上测试时,第二次调用处会超时;这与 GCC 记录的非 Linux 目标异常支持问题 描述的现象相似,但不足以据此确定根因。这里要区分标准规定与具体实现:不能因为某个实现的重试超时,就把规则理解成“抛异常也算初始化完成”。
实际使用时,可以这样选择:
- 需要跨调用点共享同一个初始化状态:使用
call_once,并确保每次传入同一个 flag。flag 不可复制、不可重置;需要一轮全新的初始化时,应使用新的 flag。 - 只需要函数内的一份延迟初始化对象:通常优先使用局部
static。自 C++11 起,它的初始化同样线程安全,写法更简单。
接口语义见 C++20 草案的 call_once 规定。
4.5 先写不变量,再确定临界区
不变量(invariant)是操作前后必须保持的规则,例如余额非负、账户总额守恒、队列长度不超过容量。锁应保护完整规则:检查前提、计算并提交修改属于一次业务操作,单独给每个字段加锁不够。
设计时写出三件事:谁拥有对象;什么锁保护哪些状态;操作在哪个时刻完整生效。这个生效点常称为线性化点,例如库存扣减成功的 CAS、持队列锁完成入队。观察者也必须遵守协议:多字段一致快照需要同时保护这些字段,单个读取安全不代表组合结果一致。
5. 多锁、死锁与进度问题
5.1 死锁是等待关系形成了环
错误示例,请勿照搬(片段;已包含 <mutex>,两个不同的 mutex 为 a、b;由两个线程分别调用下列函数):
| |
若 A 持有 a 等待 b,同时 B 持有 b 等待 a,两者永远不能继续。这个问题本身不是数据竞争或必然的未定义行为,而是活性失败。某些运行恰好让 A 先取得两把锁,就掩盖了问题。
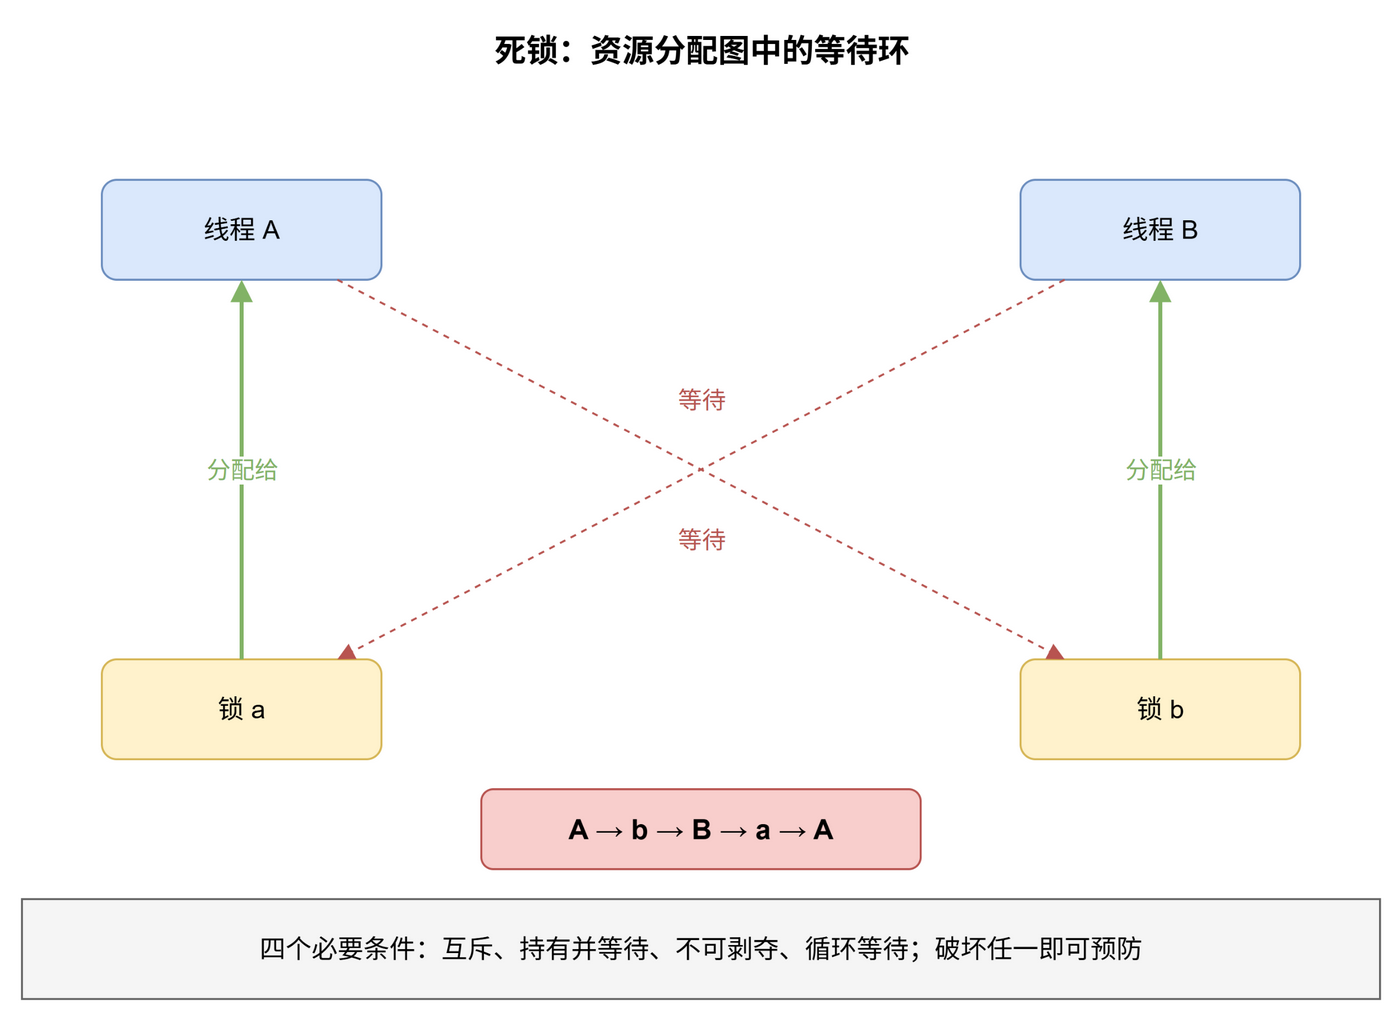
图 5-1:资源分配图。实线从锁指向持有者,虚线从线程指向它等待的锁;A → b → B → a → A 构成有向环。若省略锁节点,只保留 A 等 B、B 等 A,便得到 wait-for graph(等待关系图)。
上述相反顺序称为 ABBA。统一规定所有路径先锁 a 再锁 b,就能破坏本例的循环等待。经典的 Coffman 四个必要条件是:资源互斥、持有部分资源继续等待、资源不能被强行剥夺、循环等待。可以通过统一加锁顺序、一次安全取得多锁、减少嵌套持锁等方式破坏等待环。
示例 6(故意死锁的演示,请勿照搬):嵌套加锁 + 相反顺序复现 ABBA。上面的 bad_a/bad_b 只是片段,本例把它补全为可运行程序,可以直接观察死锁的实际表现。
| |
观察方式:在独立进程中设置超时。若形成 ABBA,程序无输出且无法自行结束;若没有遇到危险交错,也可能完成并输出 2000 2000。sleep_for() 只扩大两次加锁间的窗口,不能保证对方已取得第一把锁。超时也不能单凭一次现象证明死锁;这里的缺陷由锁依赖环说明,测试仅提供补充观察。
为什么“先后两个独立循环”的版本不会死锁。 若把每个线程写成“先用 lock_guard 守护 a 的循环跑完,再开始守护 b 的循环”,任意时刻每线程最多只持有一把锁:开始抢第二把时第一把早已析构释放,“持有并等待”条件不成立,若没有其他等待依赖,就不会由这两把锁形成 ABBA 环。代价是两个计数器的更新不再是一个原子整体——若有观察者要求两者保持一致关系,拆分写法会让它看到“只更新了一半”的中间状态。
三种写法对照:
| 写法 | 同时持有的锁 | 可能死锁? | 适用 |
|---|---|---|---|
| 先后两个单锁循环 | 最多 1 把 | 不会由这两把锁形成 ABBA(前提是无其他等待依赖) | 两份数据各自独立、无需整体一致 |
嵌套 lock_guard,顺序相反(示例 6) | 2 把 | 可能(ABBA 等待环) | 错误示范,请勿使用 |
std::lock + defer_lock(示例 7)或 scoped_lock(示例 9) | 2 把 | 避免本次多锁获取的死锁;不排除外部等待环 | 必须同时保护多份数据且顺序无法全局约定 |
规则可以提炼为:本例的独立单锁循环不会形成 ABBA,但“每次只持一把锁”并不保证整个程序无死锁:持锁等待任务、递归锁定非递归 mutex,或线程池资源耗尽,都可能使程序无法推进。顺序能全局统一时,约定统一顺序即可,不必动用 std::lock。
5.2 先关联,再统一获取:std::lock
正确片段(函数内,已包含 <mutex>;a、b 是两把不同的 mutex,调用者尚未持有它们):
| |
示例 7:两个线程按相反顺序关联两把锁。
| |
输出 20000 20000。两个线程关联锁的顺序相反:若各自直接 lock(),可能形成 §5.1 的 ABBA 死锁;在本例仅涉及这两把锁、没有其他等待依赖的前提下,交给 std::lock 统一获取可避免 ABBA 死锁。示例 9 的 std::scoped_lock 是同一语义的更简洁写法,新项目优先使用它;需要延迟加锁、提前解锁或配合条件变量时,才回到本例的 unique_lock 形态。
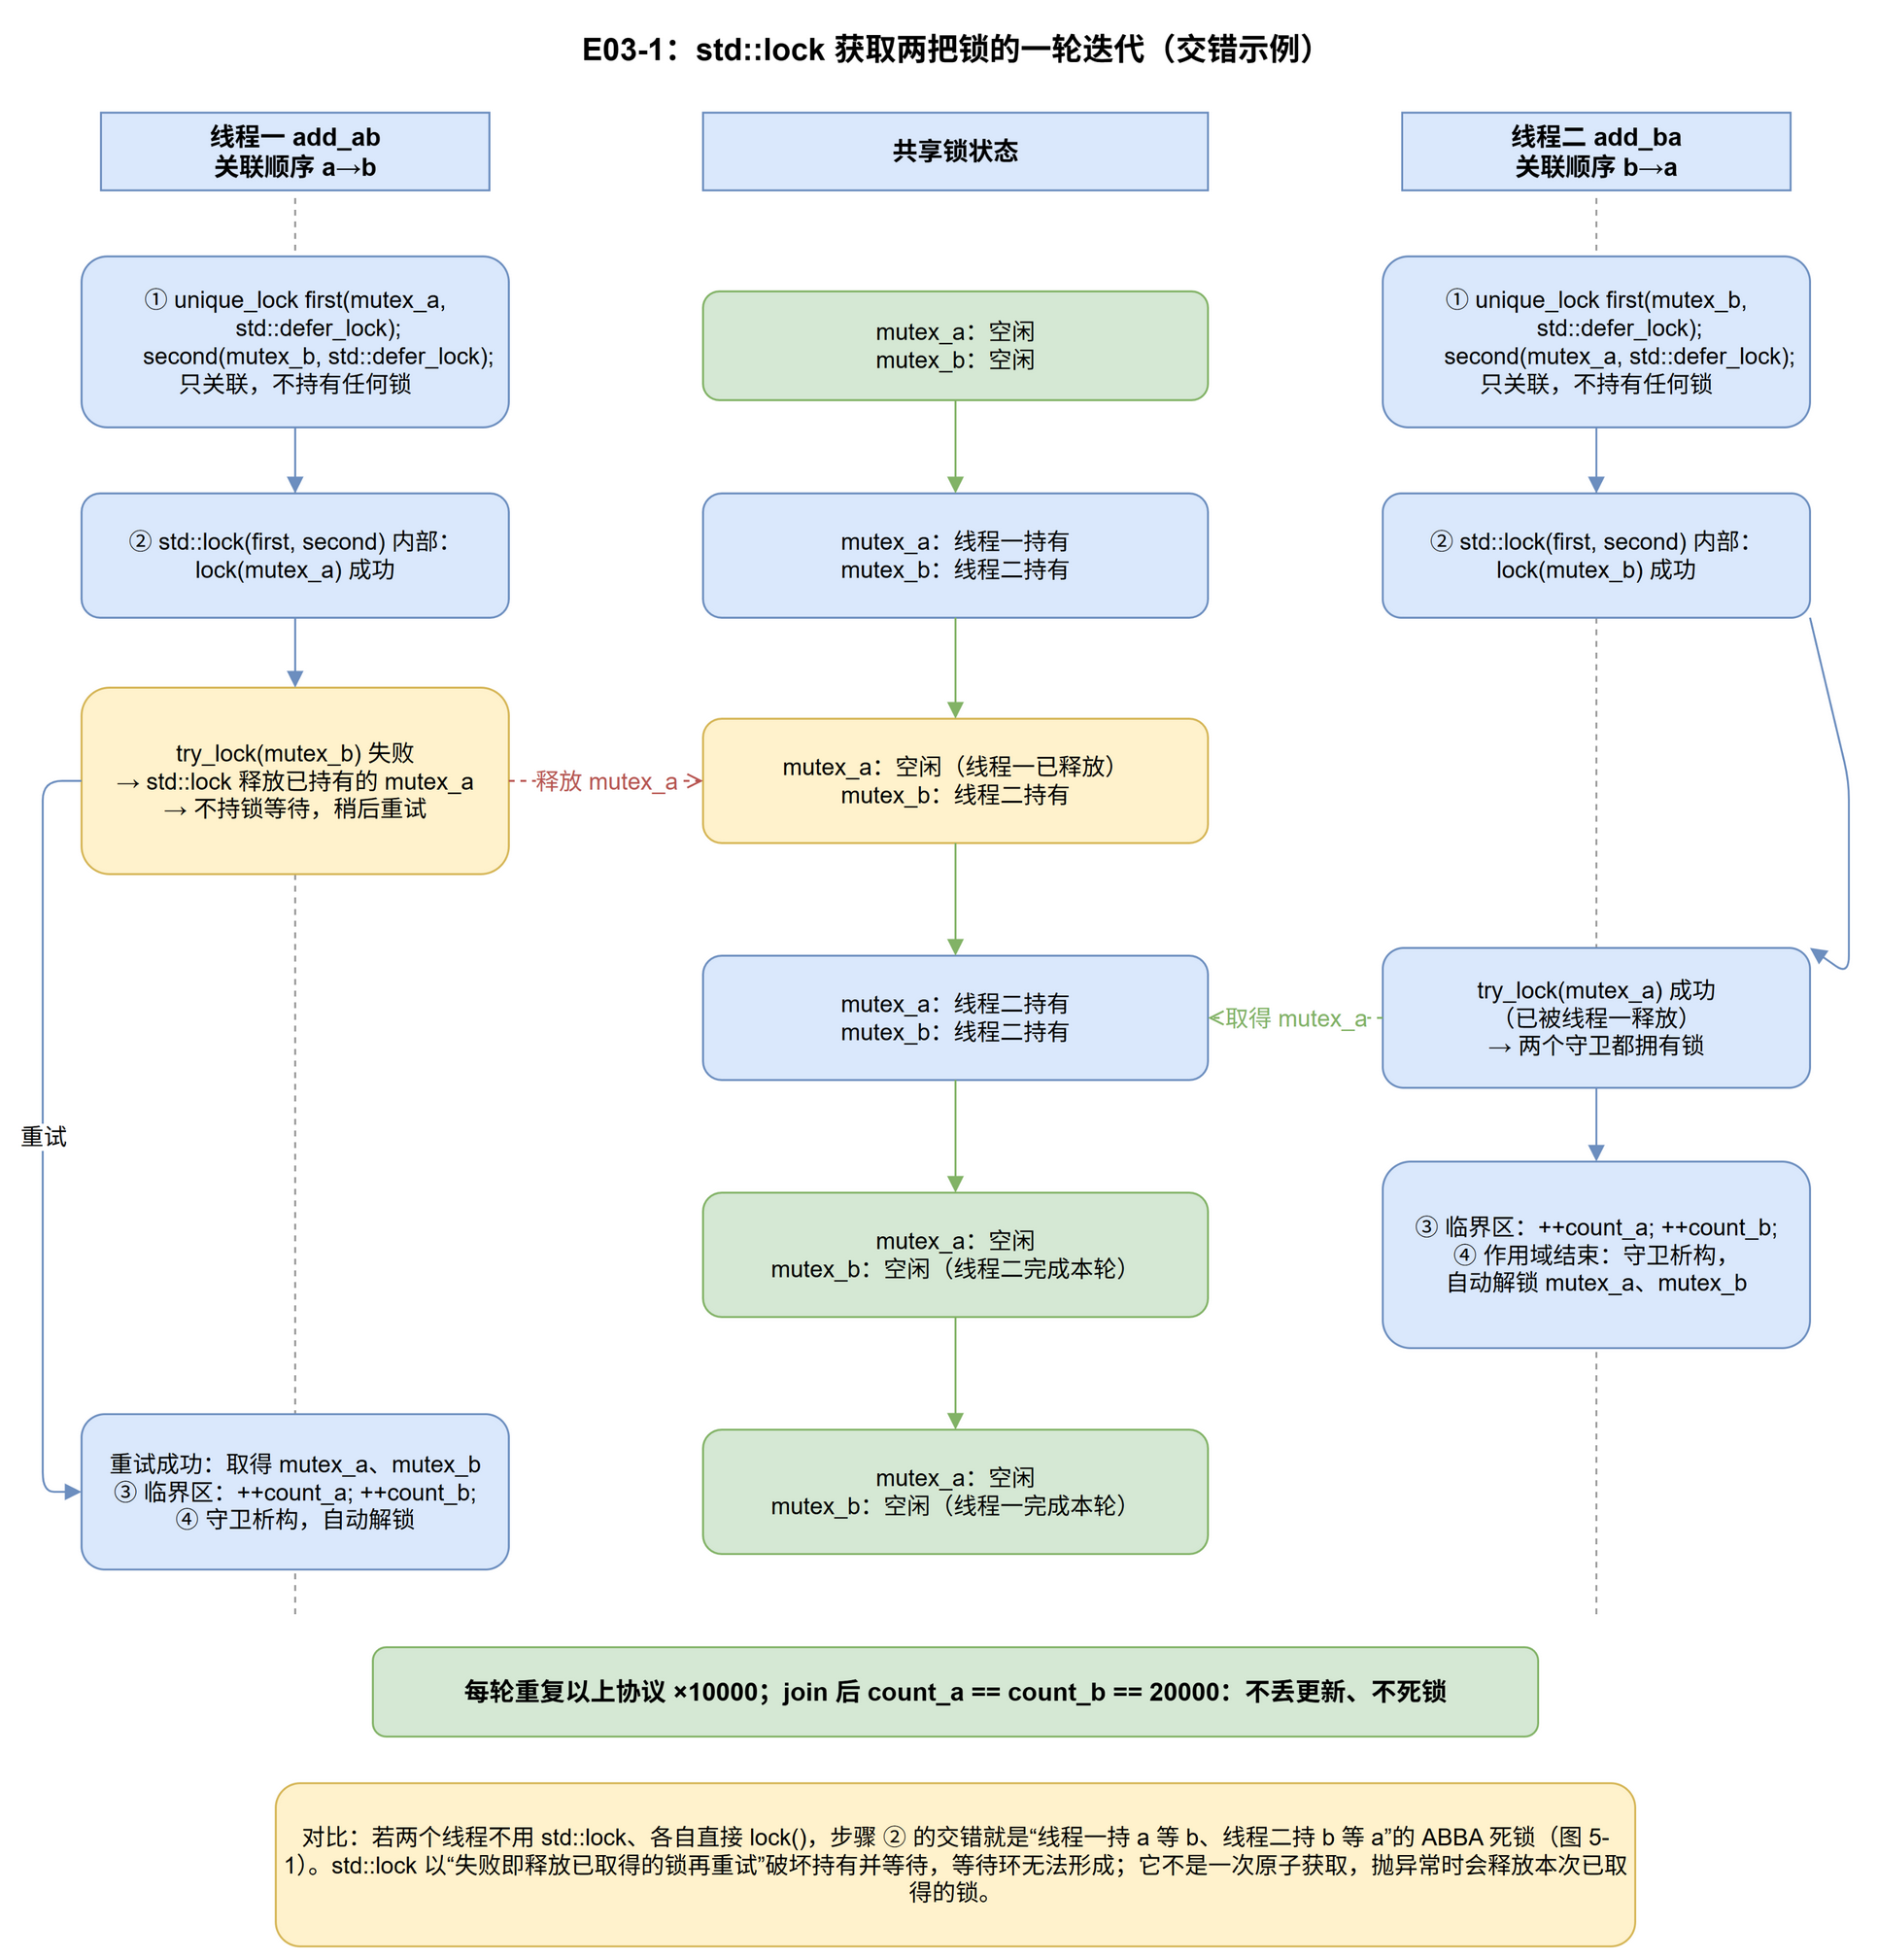
图 5-2:示例 7 一轮迭代中的加锁与解锁;这只是标准允许的一种实现与交错。
按四个时刻读图:① 关联,defer_lock 只让守卫记住 mutex;② 获取,std::lock 统一尝试,必要时释放后重试;③ 更新,成功返回后才在双锁临界区修改两个计数器;④ 释放,每轮作用域结束,两个守卫分别析构解锁。
关联顺序与加锁顺序是两回事
unique_lock(m, defer_lock)本身不加锁;即使不用std::lock,也可以稍后用成员lock()决定顺序。只有直接加锁的构造形式才在构造时锁定。std::lock不规定内部获取顺序,也不是一次原子获取;异常时会释放本次已经取得的锁。图中的“尝试—释放—重试”不能当作唯一实现。参见 多锁算法规定。
std::lock 避免本次多锁获取的死锁,但不保证公平或每个线程在有界时间内完成;持锁后再等待依赖这些锁的任务,仍会形成外部等待环。若不需要延迟或提前解锁,§5.4 的 scoped_lock 更简洁。
5.3 双锁临界区:检查与支付必须完整生效
示例 7 展示了“怎样安全地拿到两把锁”;下一个示例回答“拿到之后要保护什么”。考虑一个经典的资金场景:多个付款线程同时从账户 A 向账户 B 支付,必须防止并发导致的资金异常——透支、总额漂移、死锁。
错误示例,请勿照搬(片段;from、to 是两个账户,lock/unlock 表示对各账户 mutex 的手工加解锁):
| |
示例 8:并发支付模拟,账户 A 向账户 B 付款。
| |
输出 paid=33 failed=7 A=10 B=990。40 次请求中,每笔 30 元,1000 元只够支付 33 次,因此最终 A=10、B=990,与线程交错无关。这个确定性来自三项约束:
- 不透支:检查与扣款处于同一双锁临界区,余额判定不会被其他支付推翻。
- 总额守恒:扣款与入账一起提交;遵守双锁协议的观察者看不到中间状态。
- 统计隔离:每个线程只写自己的
paid/failed槽位,join 后由主线程汇总。
std::lock 负责避免本次双锁获取的死锁,临界区负责维护资金规则,两者职责不同。真实支付还需要金额溢出检查、持久化与失败回滚;本例只研究内存中的并发协议。
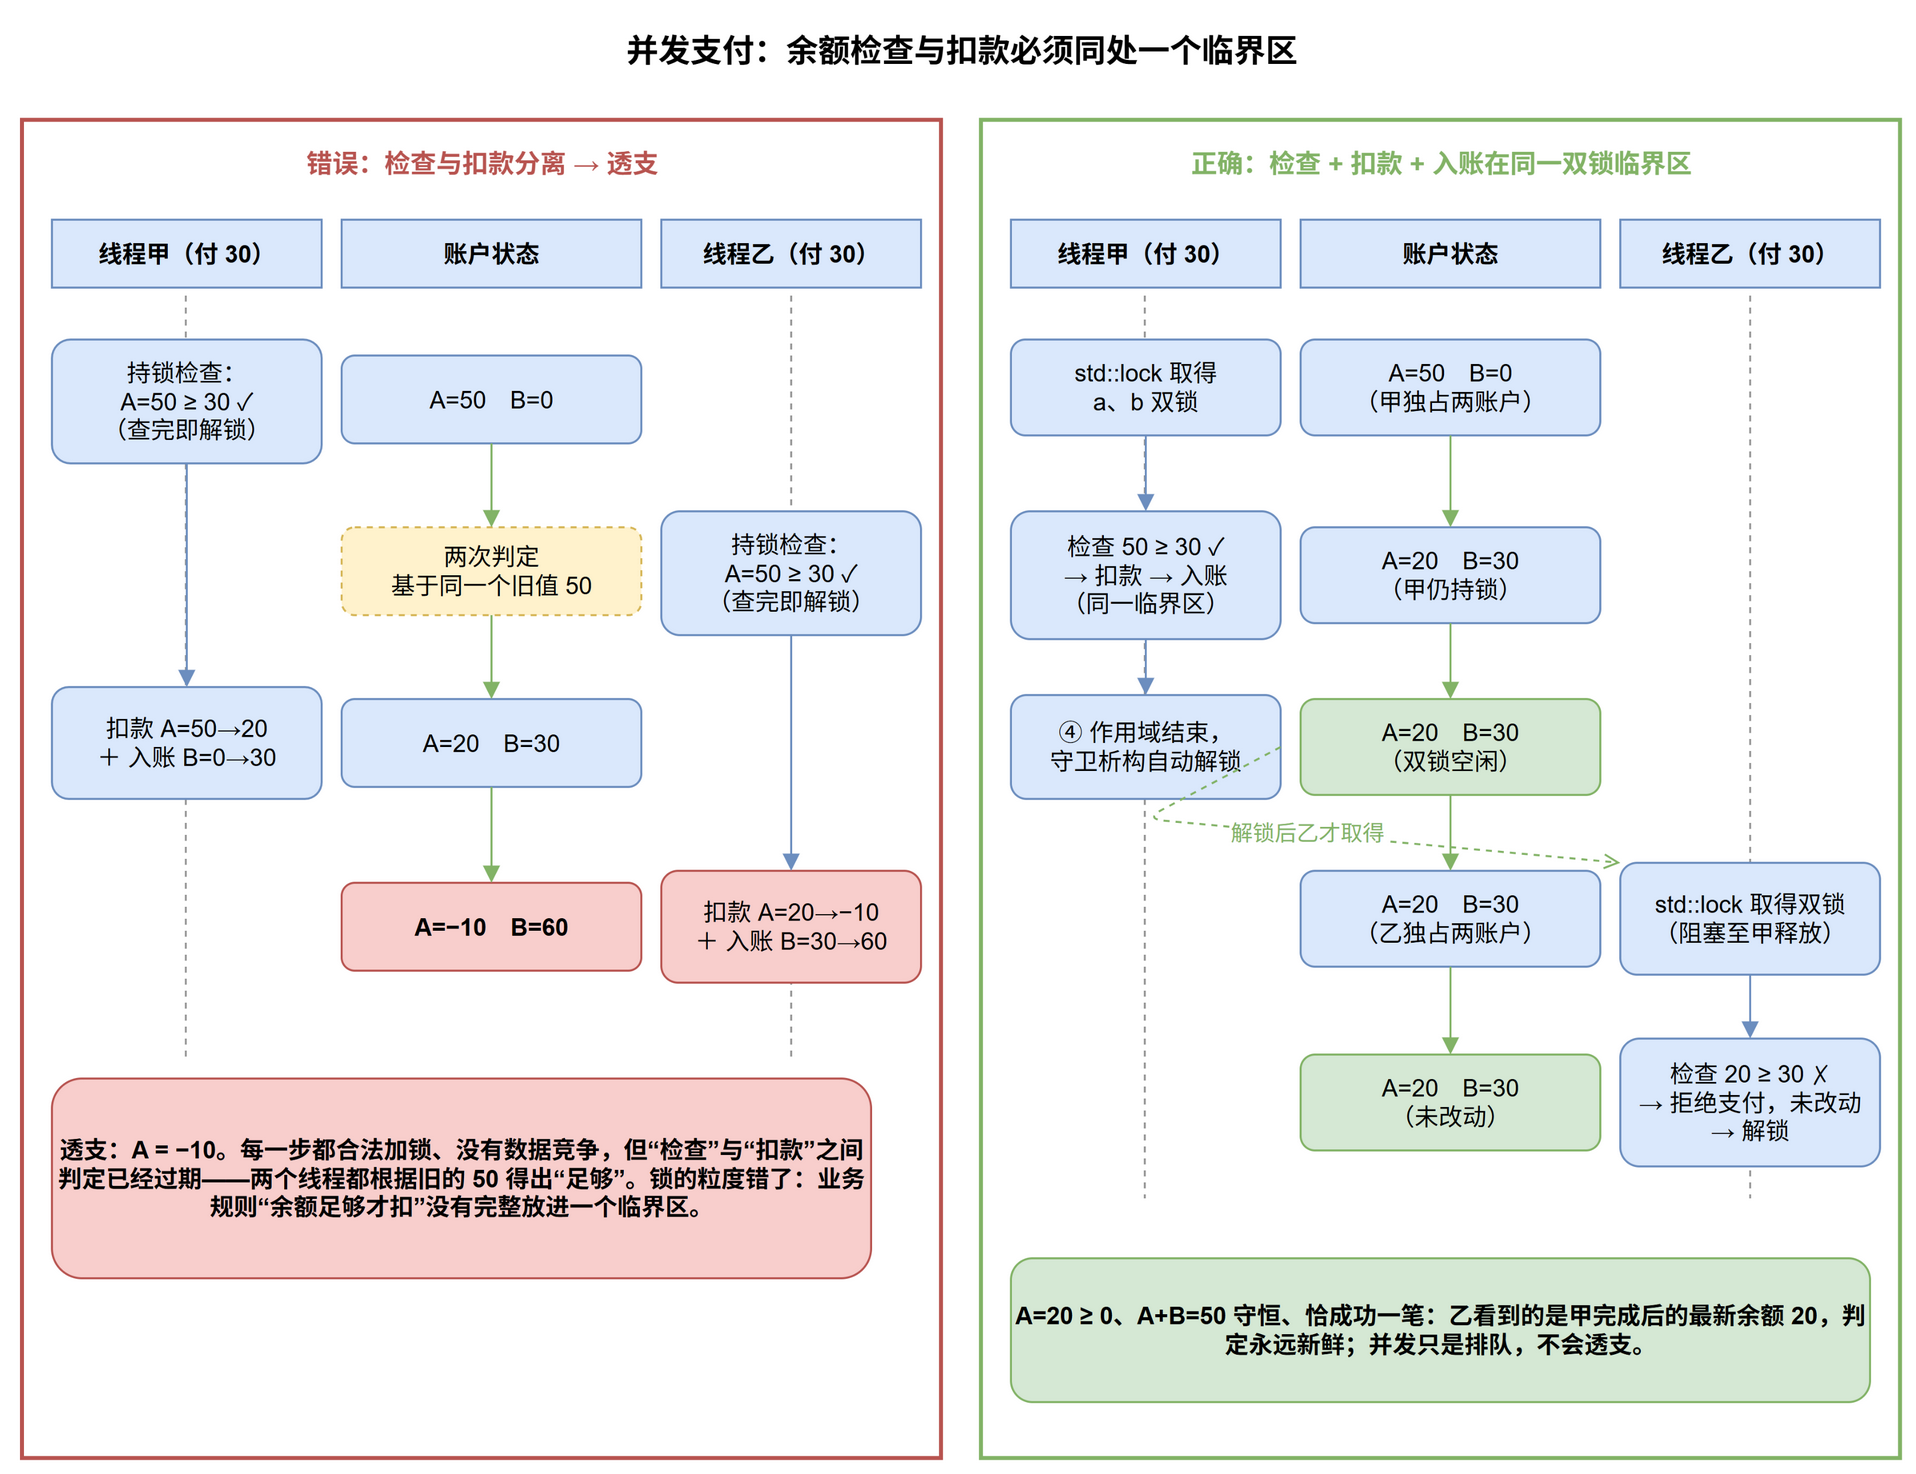
图 5-3:并发支付中“判定过期”的发生与杜绝(账户初值 A=50、B=0,两个线程各付 30)。
左图把检查和扣款分开:两线程都读到 A=50,随后各扣 30,结果 A=−10;每次访问虽有锁,旧判定仍会过期。右图把检查、扣款和入账放进同一双锁临界区:第一笔完成后 A=20,第二笔重新检查并被拒绝。这里展示的是 50 元的小反例,与示例 8 的 1000 元批量验证使用同一规则。
读取两个账户的总额也必须用 std::scoped_lock 同时持有两把锁。先锁 A 读余额、解锁,再锁 B 读余额,虽然没有 data race,却可能拼接两次转账前后的值,得到不存在的“快照”。所谓“任何同时持有两把账户锁的观察者看到总额守恒”,指遵守同一双锁协议的观察者。
5.4 用 scoped_lock 简化双向转账
示例 9:一次保护转账的两个账户。
| |
输出 110 90。固定输入确保任一转账顺序都满足余额要求,不涉及整数溢出。若扩展为真实账户系统,还应明确金额上限、失败结果和持久化规则。
scoped_lock 避免这里的多锁取得死锁,但不能修复整个程序的所有等待环。例如,持有账户锁的线程等待另一个任务,而那个任务又要账户锁,仍会死锁。
5.5 活锁与饥饿
- 活锁:线程一直重试或相互让步,看似忙碌却没有完成业务。例如两个线程同步地释放锁、重试,又同时冲突。
- 饥饿:系统整体在推进,但某个线程长期得不到锁或执行机会。标准 mutex 不承诺公平排队。
- 死锁:参与者互相等待,无法继续。
try_lock() 加循环不是万能修复,忙等可能加重竞争。优先简化资源依赖;需要公平性、超时或队列顺序时,必须把这些写进设计,而不是假设调度器会照顾每个线程。
6. 条件变量:等待状态,而不是等待通知
6.1 为什么有了锁还需要等待工具
锁回答“现在谁能访问数据”,条件变量回答“条件不满足时,怎样暂时让出执行资源”。例如消费者发现队列为空,不应该一直持锁检查:生产者需要同一把锁才能放入数据。
一个正确的条件变量协议通常有三部分:
- 共享状态:例如
ready的值或队列中保存的数据。 - 共享谓词:判断能否继续的表达式,例如
ready、closed || !queue.empty()。 - 同一把 mutex:保护状态修改和谓词检查,并配合等待操作。
先理解“谓词”:它回答“现在能不能继续”。 谓词(predicate)并不神秘,它就是一个返回 bool 的判断:true 表示“条件满足,可以继续”,false 表示“条件还不满足,需要等待”。在条件变量中,谓词通常是一个读取共享状态的 lambda,而不是一种新的数据类型。
可以把它想成在餐厅等取餐:ready 或队列内容是屏幕上的状态,“我的餐是否已经做好”是谓词,notify_one() 只是提醒顾客再看一次屏幕。提醒本身不等于餐已经做好;真正能不能取餐,仍由谓词判断。
| |
这行代码会先在持有 lock 时检查谓词。谓词为 false 时,线程释放锁并等待;被唤醒并重新取得锁后,再次检查谓词。只有谓词为 true,wait 才返回。因此,谓词可能执行多次,应保持简单,通常只读取状态,不修改业务数据。
再看队列常用的谓词:
| |
它表示“队列已经关闭,或者队列里有数据,都可以结束等待”。这里为 true 不一定表示有数据:如果队列已关闭且为空,接下来应该退出,而不是取数据。
示例 10:主线程向工作线程交付一份数据。
| |
下图展示的是”消费者先进入等待,主线程随后发布数据“这一种可能时序:
  sequenceDiagram
    autonumber
    participant C as 消费者线程
    participant M as 主线程(生产者)
    Note over C,M: 消费者先等待是一种可能时序,并非固定的调度顺序
    C->>C: unique_lock 构造,锁住 mutex
    C->>C: 首次检查谓词,ready == false
    C->>C: wait 原子地解锁 mutex 并进入等待
    Note right of C: 等待期间不持有 mutex
主线程因此可以进入临界区
    M->>M: lock_guard 构造,获得 mutex
    M->>M: payload = 21
    M->>M: ready = true
    M->>M: 离开作用域,解锁 mutex
    M->>C: notify_one(),唤醒一个等待者
    M->>M: 调用 join(),等待消费者结束
    C->>C: 收到通知后醒来,重新获得 mutex
    C->>C: 再次检查谓词,ready == true
    Note right of C: wait 返回时仍持有锁
醒来不等于条件成立,必须重查谓词
    C->>C: result = payload * 2,得到 42
    C->>C: 离开 lambda,unique_lock 自动解锁
    C-->>M: 消费者线程结束,join() 返回
    M->>M: 读取 result,断言并输出 42
关键点是:notify_one() 只负责提醒等待者醒来,真正决定能否继续的是重新加锁后的谓词检查。 如果主线程先发布数据,消费者第一次检查 ready 就会得到 true,不会进入等待;即使之前的通知没有等待者,也不影响正确性。
输出 42。线程结束前不销毁 cv、锁或数据;主线程在 join 后读取 result。本例工作线程等待、主线程负责生产,因此不需要再创建一个生产线程。
条件变量的接口一览(协议细节在 §6.2–§6.4 展开):
| 接口 | 作用 | 注意事项 |
|---|---|---|
wait(lock) | 原子地“解锁并等待”;被唤醒并重取锁后返回 | 必须配合循环或谓词重查,单独使用不安全(§6.2、§6.3) |
wait(lock, pred) | 等效于 while (!pred()) wait(lock); | 推荐形态;返回时谓词已成立 |
wait_for / wait_until | 带超时的等待;谓词重载返回谓词最终是否成立 | 超时不代表有数据(§6.4) |
notify_one() | 唤醒一个等待者 | 没有等待者时这次通知直接丢失,不会积累 |
notify_all() | 唤醒全部等待者 | 适合关闭、全局状态切换 |
native_handle() | 平台原生句柄 | 供平台特定 API 使用,牺牲可移植性 |
std::condition_variable 只能配合 std::unique_lock<std::mutex> 等待,且同时等待的线程必须使用同一个 mutex;需要其他锁类型或可中断等待时,改用更通用的 std::condition_variable_any(下篇 §9.2)。条件变量不可复制;销毁它的前提是所有等待线程都已被通知(已被通知、正在等待重新取得锁的线程不算仍阻塞在等待上),且之后不会再有新的等待。
6.2 wait 做了什么
带谓词的等待相当于以下正确片段,lock 是已持锁的 unique_lock:
| |
wait(lock) 将“释放锁并进入等待”作为一个原子步骤;被唤醒后重新取得锁,才返回。它需要 unique_lock,因为等待期间必须临时释放并重新取得锁。
谓词版本先检查条件。如果生产者早已完成,消费者直接继续,完全不需要接收到那次通知。
核心原则 状态保存事实,通知只提示重新检查。
| |
同一把锁防止生产者插入“消费者已经判定 false、但还没有进入等待”的危险空隙。对于同一个条件变量,同时等待的线程必须使用同一个 mutex。解锁建立的数据可见性也让消费者安全读取 payload。
6.3 丢失唤醒与虚假唤醒
错误示例,请勿照搬(片段;ready 在这里是 atomic,故意排除普通变量的数据竞争):
| |
生产者可能恰好在消费者检查之后、进入等待之前通知;通知不保存为“将来的票”,消费者可能永远等下去。这里即使没有 data race,等待协议仍然错误。若 ready 改成无保护普通 bool,还会额外引入数据竞争。修复就是示例 10 的同锁谓词协议。
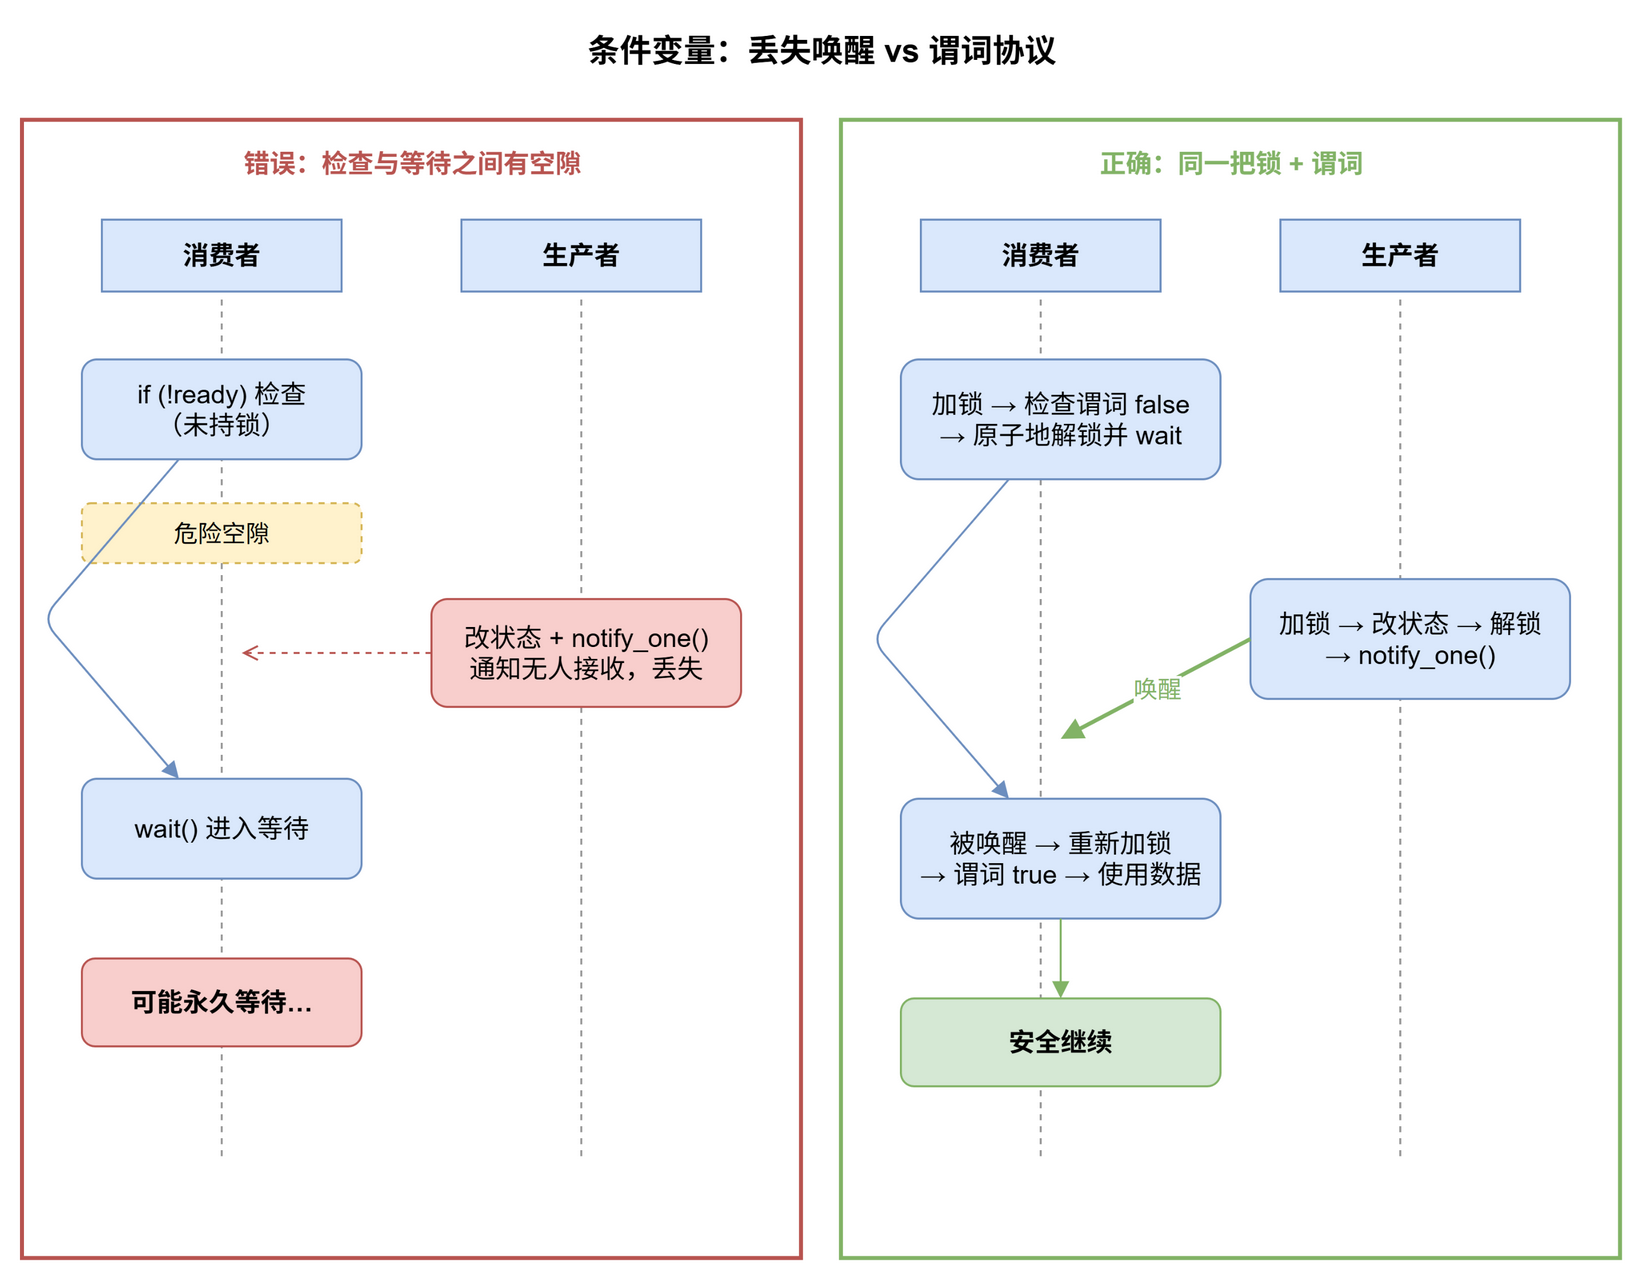
图 6-1:左为丢失唤醒的错误时序——通知落入"检查与等待之间的空隙”;右为同锁谓词协议的正确时序——同一把锁消除了这个空隙。
虚假唤醒指没有对应业务通知也可能结束一次等待。即使没有虚假唤醒,多消费者中也可能由另一个消费者先拿走了数据。单次 if 或不带检查的 wait() 不能证明条件成立,必须循环重新判断。
notify_one() 唤醒一个等待者,适合同种等待条件下新增一个可消费任务;notify_all() 唤醒所有等待者,适合关闭、全局状态切换。多个不同谓词共用一个条件变量时,notify_one() 可能选中无法继续的线程,应拆分条件变量或使用适当的全体通知。
通知可以在锁内,也可以在锁外;核心要求是状态协议与对象寿命正确。锁外通知前若对象可能被销毁,还需要额外的生命周期约束。通知不等于对任意共享数据的自动保护。接口语义见 条件变量等待规定。
6.4 超时、退出与关闭
wait_for 的谓词重载返回谓词最终是否成立,不能把“醒了”理解成“有数据”。若手写循环,每次重新等完整时长可能无限延长总等待;应基于 steady_clock 计算一次绝对截止时间,反复 wait_until,或者直接用谓词重载。超时不是实时返回保证:调度延迟以及重新取得 mutex 都可能让实际返回更晚。
队列通常使用 closed || !queue.empty():醒后如果有数据就取数据;只有“已关闭且为空”才退出。必须先在锁内设置 closed,再通知等待者,最后回收线程并销毁队列。这比发送一个无法区分业务数据的“特殊数字”更明确。下篇 §11 的任务处理器会实现这个协议。
有界队列还需要生产者等待容量:生产者谓词为 closed || size < capacity,消费者谓词为 closed || !empty。用同一把 mutex 保护队列与关闭标志,通常分别使用“非满”和“非空”两个条件变量。成功取出通知生产者,成功放入通知消费者;关闭通知两组等待者。关闭后,已经阻塞的生产者也必须醒来并拒绝入队;消费者排空后退出。容量为零应在构造时拒绝。销毁前调用者必须先关闭并回收所有访问线程。
7. 从线程转向任务:结果如何回来
7.1 线程、任务与共享状态
§3.4 已用 async 完成一次平方计算;本章解释它背后的结果通道,并扩展到显式交付与队列调度。先区分“执行谁来安排”和“结果由谁保存”,再选择接口。
线程是执行资源,任务是要完成的工作,future 是取得某次工作结果的句柄。一个线程可以处理许多任务;拥有一个 future 并不意味着已经有线程在执行任务。
future<T> 与生产结果的一端通过一个异步共享状态相连。不要把它和“随意共享业务变量”混为一谈:这个状态由标准库管理,用于保存结果、异常和就绪信息。
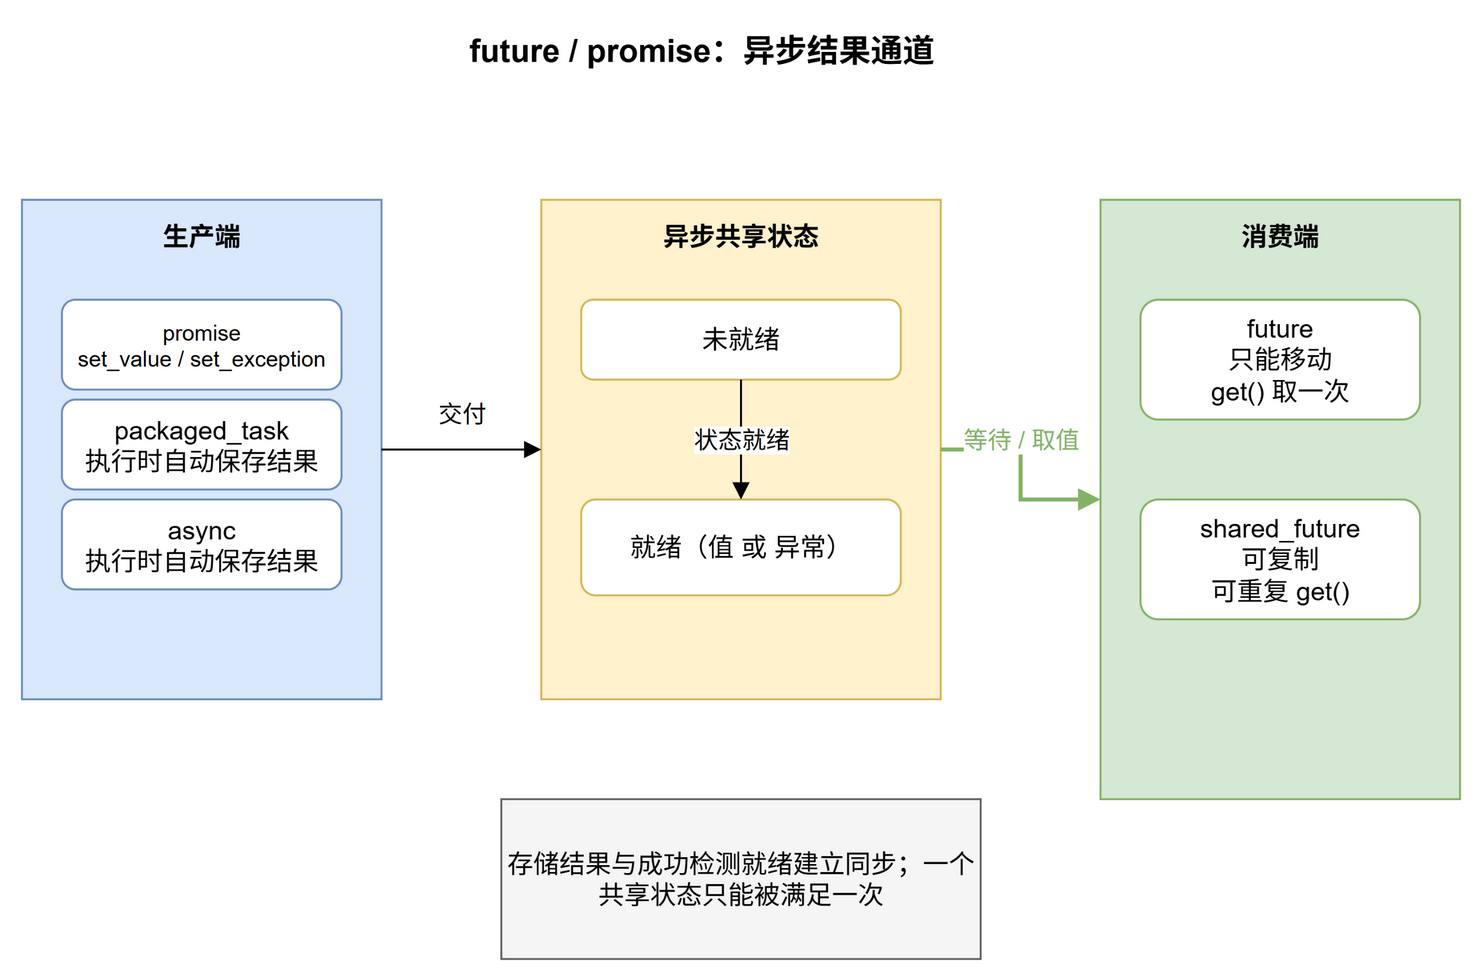
图 7-1:异步结果通道。生产端把值或异常写入共享状态并使其就绪;消费端通过 future 等待并读取。
“有状态”和“状态就绪”是两回事。默认构造的 future 没有关联状态;一个有效 future 可能仍在等待结果。
| 操作 | 等待吗? | 是否消费结果? |
|---|---|---|
valid() | 不等待计算 | 只判断是否关联共享状态,不表示任务成功或完成 |
wait() | 未就绪时等待;延迟任务可在这里执行 | 不取值,不抛出已存储的任务异常 |
wait_for() / wait_until() | 在指定等待范围内检查状态 | 返回 ready、timeout 或 deferred |
future<T>::get() | 必要时等待 | 取出值或重抛异常,并释放本句柄的状态关联 |
shared_future<T>::get() | 必要时等待 | 可重复读取,普通 T 返回 const T& |
普通 future 只能移动,不能复制;成功调用 share() 后,原 future 失去状态。对无状态 future 调用 get() 或等待函数违反接口要求,不能依赖实现一定抛出友好的 future_error。先写清所有权,避免重复消费,也不要让一个线程移动或消费句柄时另一个线程仍在访问该句柄。
就绪通知与成功检测到就绪之间提供同步,因此结果取得后可安全使用已经发布的数据;但返回引用或指针仍要求被引用对象存活,future 不会替外部对象续命。参见 异步共享状态 与 future 的消费语义。
7.2 promise:显式交付值或异常
promise<T> 是写入端:通常先 get_future() 取得唯一的读取端,再将 promise 移给负责完成工作的线程。一个状态只能满足一次,重复取 future 或重复设置结果会产生 future_error。
promise 的接口一览(promise<T&> 与 promise<void> 是特化,语义对应相同):
| 接口 | 作用 | 注意事项 |
|---|---|---|
get_future() | 取得与本状态关联的唯一读取端 | 每个状态只能成功调用一次;通常在 promise 被移走之前取得(移出后的源对象不再拥有状态,接管它的新对象仍可取得) |
set_value(v) | 把结果值写入共享状态并使其就绪 | 调用时状态即就绪,不等线程函数返回;promise<void> 用无参 set_value() |
set_exception(ep) | 把异常指针写入共享状态并使其就绪 | 等待方在 get() 处重抛该异常;通常配合 std::current_exception() 使用 |
set_value_at_thread_exit(v) / set_exception_at_thread_exit(ep) | 写入结果,但延迟到线程退出时才使状态就绪 | 就绪更晚:等待方会多等到线程函数返回、线程局部对象销毁之后 |
| 析构 | 状态若从未被满足,存入 broken_promise 并使状态就绪 | 写入端放弃未满足状态时让它带异常就绪(示例 11 第三条路径);仍活着却永不交付的 promise 可能使等待永久持续 |
示例 11:正常结果、业务异常与 broken promise。
| |
set_value() 通常在调用时使状态就绪,并不等到线程函数返回。消费者读到结果后,生产线程可能还在执行收尾操作;如果需要证明整个线程已结束,仍要 join。另有 set_value_at_thread_exit() 等接口用于推迟就绪,本文不涉及它们。
销毁未满足的 promise 会让消费者收到 broken_promise,而不是保证它永远等待。但是,如果 promise 一直活着、没有任何路径设置结果或销毁它,消费者仍可能永久等待。promise 的协议错误和任务本身的业务异常是不同的错误来源。参见 promise 规定。
7.3 packaged_task:把可调用对象和结果通道绑在一起
它保存一个可调用对象,调用任务时自动把返回值或抛出的异常存进共享状态。它不会自己创建线程。适合“先封装任务,稍后交给工作线程”的设计。
接口要点:
- 模板参数是函数签名,例如
packaged_task<int(int)>表示“接收 int、产出 int”;构造时传入任何匹配签名的可调用对象。 get_future()对同一个共享状态只能成功调用一次,且只能在仍拥有状态的对象上调用;通常在任务被移走之前取得读取端(移出后的源对象已无状态,再调用会抛出future_error;接管了任务的新对象仍可以取得)。operator()(args...)执行任务并交付结果;同一共享状态只能成功交付一次;调用目标抛出异常也会消耗该状态的交付机会,对已执行过的任务再次调用会抛出future_error。需要复用时先reset():它放弃旧共享状态并建立新状态——此前取得的 future 并不失效:若旧任务已执行,它仍持有原结果或异常;若旧任务未执行,放弃旧状态会使它收到broken_promise;必须针对新状态重新调用get_future()取得新的读取端。- 只能移动,不能复制;这决定了示例 12 中任务以
std::move移交线程的写法。
示例 12:将任务移入线程。
| |
输出 81。移动后的原任务不再拥有这个状态。未执行就销毁的有效 packaged_task 同样会放弃状态,消费者可收到 broken_promise。一般把任务看成一次性对象;重复调用、状态重置会使协议复杂,不应当作普通可重复函数随意使用。
7.4 async:简洁,但要选择执行策略
示例 4 已演示返回值和异常;示例 13 只补充两个任务的结果合并与 deferred 的触发时机,避免重复前面的示例。
| 策略 | 行为 |
|---|---|
std::launch::async | 以新执行线程的语义执行,返回 future;创建资源可能失败 |
std::launch::deferred | 保存任务;首次非定时等待(如 get()、wait())在调用者线程执行它 |
| 不显式传策略 | 相当于允许 async 或 deferred,由实现选择;不保证并行执行 |
示例 13:并发结果与延迟执行。
| |
输出 42 7。这些工作很小,只演示行为,不暗示使用两个线程比直接相加更快。future 没有标准的取消接口;超时只代表此次等待结束,不代表任务被取消或失败。
错误示例,请勿照搬(片段;work_a、work_b 为已有函数):
| |
第一行临时 future 在分号处销毁,可能在那里等待任务结束,导致本想重叠的任务依次执行。这通常不是未定义行为,而是析构时的隐含等待。修复是像示例 13 一样保存两个句柄,然后显式取得结果。
7.5 析构到底等不等待
必须根据状态来源判断,而不能只看类型名 future:
- promise / packaged_task 创建的状态:future 析构释放关联,通常不等待生产者线程;线程的寿命另行管理。
- 选择了 async 策略的
std::async状态:尚未完成、且最后一个引用释放时,释放操作可能等待关联线程完成。移动给别人或者转成 shared_future 后,最后释放者也可能承担等待。 - deferred 状态:若从未被非定时等待触发,释放它不会为了“做完工作”而执行任务。
析构与锁 不要在持有任务所需锁时销毁可能等待的最后一个句柄,也不要把 future 析构当作主动取消。
wait() 或析构不会把任务中保存的异常抛给调用方;要观察异常,需要 get()。未取出的异常可能随状态销毁而被丢弃。策略与等待规则见 async 规范。
7.6 shared_future:多方读取同一份结果
它可以复制,每个使用线程持有自己的句柄副本。普通 T 的 get() 返回共享状态内的 const T&,必须让至少一个相关句柄维持状态寿命;需要长期保存时复制结果。T&、void 有各自的返回语义。
示例 14:将同一份配置提供给两个线程。
| |
输出 5 5。两个线程只读同一个字符串,分别写数组的不同元素,主线程回收后读取。shared_future 保证共享状态读取机制,不保证结果内部指针指向的可变对象线程安全;共享 shared_ptr<Mutable> 的结果也不能省去对 Mutable 的同步。
上篇到这里结束。下篇将从原子变量与内存序讲起,继续介绍 C++20 的取消与协调工具、性能与测试方面的工程实践,并把前面的锁、条件变量和 future 组合成一个可关闭的并发任务处理器。