
本文是 C++ 并发与并行编程系列的下篇。上篇介绍了执行模型、线程生命周期、互斥锁、条件变量与 future 结果通道;本篇继续讨论原子变量与内存序、C++20 的取消与协调工具(stop_token、semaphore、latch、barrier)、从“正确”走向“可维护、可测量”的工程实践,最后实现一个可关闭的并发平方任务处理器。
为便于前后引用,章节号与示例编号沿用上篇:本篇从第 8 章、示例 15 开始,引用上篇内容时会注明“上篇”。
8. 原子变量:先明确边界,再谈内存序
8.1 一次原子操作,不等于一段原子业务
std::atomic<T> 为适用的类型提供不可被拆开的操作。整数原子常用 load、store、exchange 和 fetch_add。fetch_add 返回修改前的值,并把读、加、写作为一次原子读改写。
常用操作如下。load、store、exchange、fetch_* 和 CAS 的相应重载可显式指定内存序,省略时默认 seq_cst;运算符形式固定使用 seq_cst,不接收内存序参数。无锁能力查询不涉及内存序(§8.3):
| 操作 | 语义 | 返回 |
|---|---|---|
load() | 原子读取当前值 | 读到的值 |
store(v) | 原子写入 | 无 |
exchange(v) | 原子替换 | 替换前的值 |
fetch_add(n) / fetch_sub(n) | 原子加 / 减(适用的整数、指针;C++20 也支持浮点特化) | 修改前的值 |
operator++ / operator+= 等 | 对应 fetch 操作的简写 | 前缀 ++ 返回修改后的值;后缀 ++ 与 fetch_add 一样返回修改前的值 |
compare_exchange_weak/strong(expected, desired) | 仍等于 expected 才替换为 desired(§8.7) | 是否成功;失败时 expected 被更新为观察到的值 |
is_lock_free() / is_always_lock_free | 查询该对象 / 类型是否无锁实现 | 运行期 / 编译期答案 |
赋值运算符执行默认内存序的存储并返回写入值,隐式类型转换执行默认内存序的 load;因此 count = count + 1 仍是读、写两次独立操作,与下面错误片段的问题相同。C++20 还提供原子 wait / notify_one / notify_all;旧 TDM-GCC 环境的缺失见上篇 §2.2,本文为保持示例连贯不使用它们。类型与操作规定见 C++20 草案的 atomic 泛型。
示例 15:默认内存序的原子计数。
| |
错误示例,请勿照搬(片段;count 是 atomic):
| |
这没有对 count 的数据竞争,却可能丢更新:两个线程分别 load 同一个值,再 store 同一个新值。改用 fetch_add 或 ++count。
多个 atomic 也不会自动组成一个事务。例如两个账户余额分别是 atomic,先扣 A 再加 B,观察者可以在两步之间看到总额减少;即使全用默认内存序也一样。用锁保护共同不变量,通常比设计多变量无锁协议容易维护。
原子对象也必须先构造、后发布,并在无人访问后销毁。atomic<T> 并不对任意 T 都可用,也不保证所有类型都 lock-free;可以检查 is_lock_free() 或 is_always_lock_free。某些类型与目标需要额外链接 libatomic,本文的小整数示例没有这种需求。
8.2 happens-before:正确性证明的连接线
内存模型不是“刷新某级缓存”的编程接口。它规定哪些执行与观察结果被允许,编译器和硬件负责实现。
先区分三种关系:
- sequenced-before:同一线程内,求值规则确定的先后关系;不是任意表达式都能直接按书写顺序推断。
- synchronizes-with:标准指定的跨线程同步边,例如解锁到随后加锁、线程结束到 join 返回。
- happens-before:将线程内顺序和跨线程同步连接起来形成的先后关系。本文不使用
consume,可以沿这些连接及传递性进行推导。
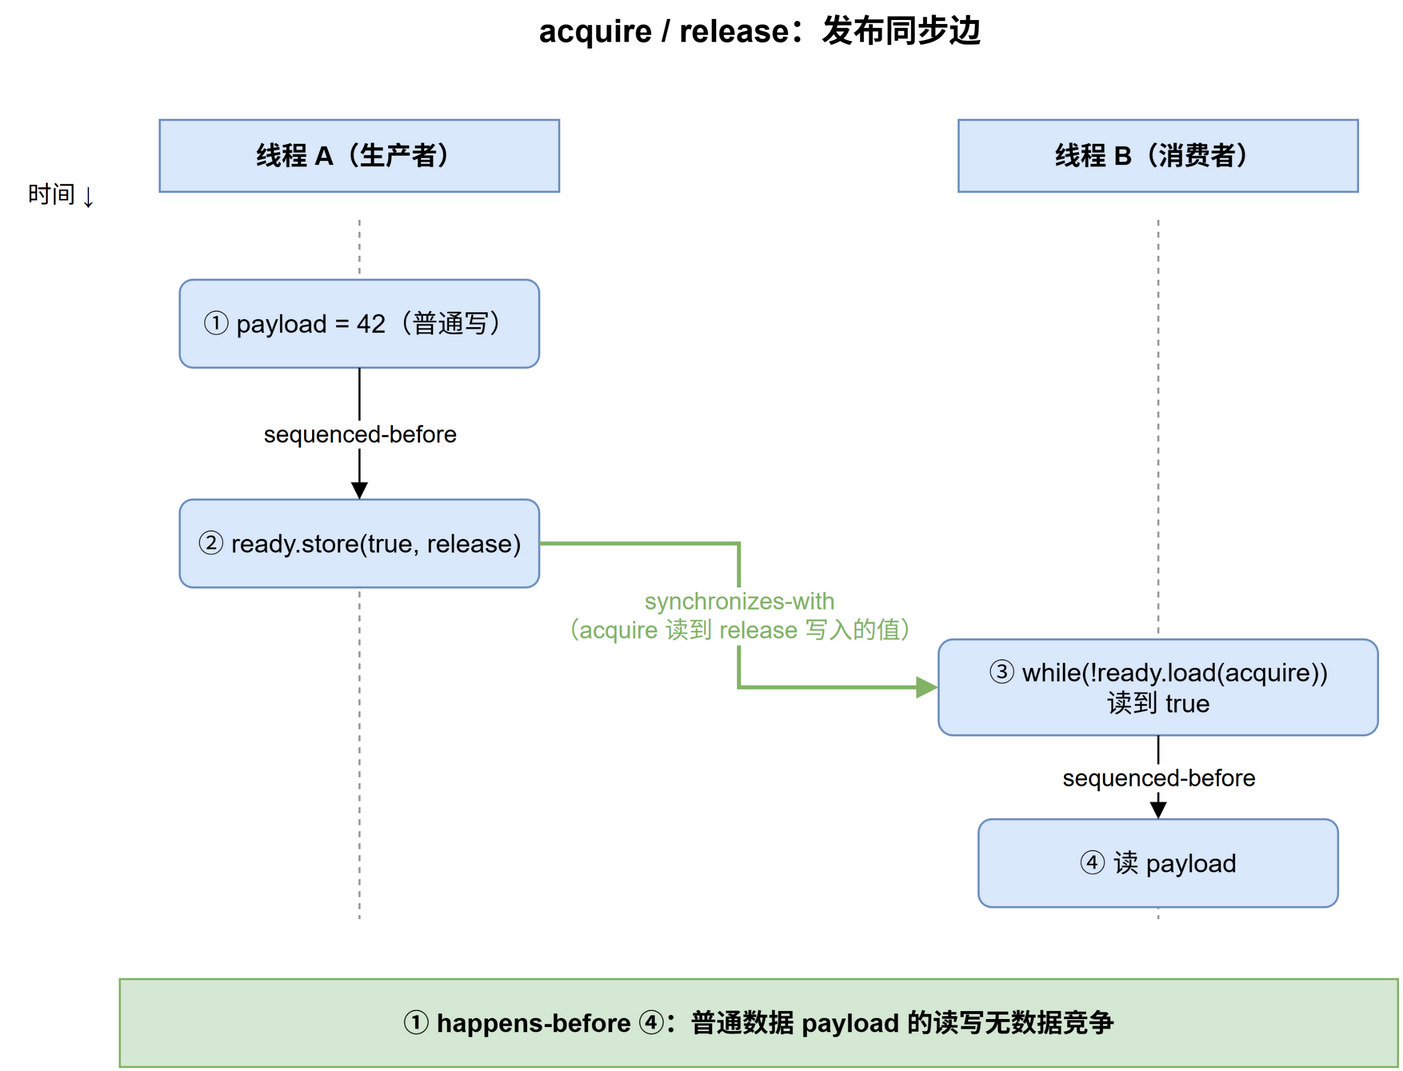
图 8-1:一条完整的同步链(以示例 16 的发布为例)。线程 A 内 sequenced-before 把"写 payload"接到 release store;release 与读到该值的 acquire load 构成 synchronizes-with;再接线程 B 内的 sequenced-before,得出"写 payload happens-before 读 payload"。解锁与随后加锁之间的同步边同理。
**modification order(修改顺序)**是每个原子对象自己的全部修改操作所构成的全序,所有线程必须遵守该对象的原子一致性约束。不同原子对象各有自己的修改顺序,它们不会自动合成一个全局顺序;relaxed 也保留这一点。
真实时间上“似乎已经先写了”,不等于建立了 happens-before;sleep_for()、输出日志、CPU 核心数都不是所需证明。无锁代码尤其不能只根据某台 x86 机器的运行现象推断跨平台正确性。
8.3 内存序各自负责什么
| 内存序 | 主要作用 | 合适的起点 |
|---|---|---|
seq_cst | 保留相应 acquire/release 作用,并对所有 seq_cst 操作提供一个满足标准约束的单一全序 | 默认选择 |
release | 在匹配的同步关系中发布之前的操作 | 发布就绪状态的 store |
acquire | 在匹配的同步关系中接收发布的操作 | 观察就绪状态的 load |
acq_rel | 同时取得和发布 | 需要双向同步的读改写 |
relaxed | 保证本次原子访问及该对象的修改顺序,不借此发布其他数据 | 不承担发布职责的独立计数 |
consume | 基于数据依赖传递发布关系,规则比 acquire 更复杂 | 标准自 C++17 起注明劝阻使用(C++26 起正式废弃),一般代码应避免直接使用 |
C++20 实际定义六种内存序,完整名称分别是 std::memory_order_relaxed、std::memory_order_consume、std::memory_order_acquire、std::memory_order_release、std::memory_order_acq_rel、std::memory_order_seq_cst。consume 长期存在实现与使用上的困难,主流实现通常按 acquire 处理,C++26 起被正式废弃;本文避免直接使用。load 不能用 release 或 acq_rel;store 不能用 consume、acquire 或 acq_rel。
release 与 acquire 只有实际接上才同步:必须作用于同一个原子对象,且 acquire 读取到相应 release 写入的值,或者读取到由它起始的 release sequence 中的值。不是任意两个写着这两个单词的操作都能配对。
本文只用一次发布来避免复杂性。C++20 中,release sequence 是该对象修改顺序中,以 release 操作为首、后续全部由原子读改写组成的最长连续序列;中间插入普通原子 store 就会截断,单纯 load 不属于修改,不截断它;不能照搬旧教材中“同线程普通原子 store 也可延续该序列”的说法(P0982R1 提案有意收窄了这一定义,属于对旧规则的破坏性修改,旧代码若依赖被删去的延续规则会失去同步保证)。严格规则见 C++20 内存序。
8.4 用一次发布证明 acquire/release
示例 16:发布初始化后的普通数据。
| |
证明分为三步:
- 写
payload在线程内先于 release store。 - 初始值是 false,只有生产者写 true,因此读到 true 的 acquire 必定读到了该次发布。
- 该 acquire 先于读
payload,串起 happens-before,因此普通整数的读写没有数据竞争。
错误示例,请勿照搬(片段,表示对示例 16 的错误替换):
| |
原子标记本身安全,但它不再建立数据发布的同步,普通 payload 的冲突访问缺少 happens-before,产生未定义行为。某个处理器上“经常有效”不能修复 C++ 层面的错误。
本例弱内存序是为展示同步边而使用,不是经测量后的性能建议;保留默认 seq_cst 同样正确。实际等待时间可能较长时应使用条件变量;忙等与 yield 不保证公平性或有界响应时间。C++20 还提供原子 wait/notify,旧工具链的缺失记录见上篇 §2.2;本文仍用条件变量统一等待协议。
不能把 ready 简单清回 false,就把一次发布协议扩展成反复传输:生产者可能在消费者还读旧数据时覆盖它。多轮交接要补充消费确认、互斥或队列协议。
8.5 seq_cst 保证什么,不保证什么
如果程序没有数据竞争,相关原子操作全部采用 seq_cst,可以用“所有原子操作按一个与各线程顺序一致的全局顺序交错”的方式推理。这个全序不是给整段函数加锁,也不保证多个 load 构成同一时刻的快照,更不保证实时调度或读取某个墙钟时刻的“最新值”。
例如 x、y 初始为 0,两个线程都使用 seq_cst:
| |
不能同时得到 rA == 0 与 rB == 0:那要求两个 load 各自排在对方的 store 前面,与线程内顺序一起构成不可能的环。若改成 relaxed,这种结果是允许的;即使改成 release store 和 acquire load,读到初始 0 时也没有接上对方的发布,仍不能排除该结果。
混合弱内存序与 seq_cst 后,不能再把“全局交错”套用到所有操作;正式约束更细。没有明确的性能需求时,保持默认内存序比零散削弱操作更容易证明正确。seq_cst 不会修复未受保护的普通数据访问、悬空引用或业务操作被拆分的问题。
8.6 什么时候 relaxed 已经足够
示例 15 如果只要求独立计数,并在所有线程 join 后读取最终值,可以把其中 fetch_add 和最终 load 改为 relaxed:原子读改写防止丢更新,join 负责线程结束后的同步,计数器本身不发布其他业务数据。
这是一份正确性论证,不是速度保证;是否值得改需要测量。不要把这个结论推广成“看到计数达到 N,就能直接读取 N 个普通结果”:如果把计数当作就绪信号,又需要独立证明数据发布。
8.7 CAS:如果还没变,就替换
CAS 即 compare-and-swap,在 C++ 中由 compare_exchange_weak/strong 提供。理解 expected 是关键:它既是输入,也可能被修改。
| 结果 | 原子对象 | expected |
|---|---|---|
| 成功,返回 true | 写入 desired | 保留本次比较用的值 |
| 失败,返回 false | 不执行本次写入 | 更新为此次观察到的原子值 |
weak 允许伪失败:即使比较相等,也可能报告失败,因此通常放在循环中。strong 没有这种伪失败,但其他线程修改值仍会令它失败。CAS 比较不是调用自定义 operator==;本文使用简单整数,避免复杂表示问题。
示例 17:库存大于零时才扣减。
| |
输出 100,各线程分别拿到多少不确定。成功的 CAS 是扣减生效的唯一时刻:只有仍等于正数 expected 时才会写入 expected 减一,因此不会扣成负数。
错误示例,请勿照搬(片段):
| |
这可能在竞争后写入过时结果,造成逻辑错误,通常不是对原子 stock 的数据竞争。修复是像示例 17 一样每轮重新检查前提并计算 desired。重试体也不能执行付款、发送通知等不可重复副作用;这些应在操作成功之后执行。
如需显式内存序,CAS 有成功序和失败序:成功是读改写,失败只是读,因此失败序不能是 release 或 acq_rel。旧版“失败序不得强于成功序”的前置条件自 C++17 起已经移除,不应把它当作 C++20 规则;成功序用于读改写,失败序仍须是合法读取序。工程上采用熟悉且已论证的组合,如 acq_rel/acquire 或 release/relaxed;这里使用默认值,不需要手动搭配。单内存序重载会自动调整失败序:acq_rel 对应 acquire,release 对应 relaxed。具体规定见 C++20 原子操作。
CAS 不意味着整个算法 lock-free,更不意味着某个线程不会饥饿。若值经历 A→B→A,CAS 可能看不出中间变化,这称为 ABA;涉及指针时还要处理对象回收和悬空访问。不建议从这个整数例子直接跳到自制无锁链表。
缓解 ABA 的常见思路是 tagged pointer(标记指针):把指针与版本号作为同一个原子对象一起比较和更新。A → B → A 时,只要版本号没有回绕,CAS 就能发现变化。有限位数的标签可能回绕,必须证明旧观察仍在使用时不会复用同一标签。分开更新一个普通计数器与一个原子指针不能提供这个保证;宽 CAS 的可用性、是否 lock-free 及指针位编码都取决于实现,不能假定 64 位机器自动支持。
ABA 检测和对象寿命是两件事。shared_ptr 的所有权可以延长对象寿命,但共享指针变量自身仍需同步,且引用计数不能泛化为消除所有逻辑 ABA。hazard pointer(风险指针)通过发布正在访问的节点并复核,阻止相应节点过早回收;epoch reclamation(基于时期的回收)等待旧访问者越过安全时期再释放节点。它们需要完整的回收协议,也不自动解决所有业务状态的 A → B → A。本节只建立边界,不实现无锁链表。
8.8 std::atomic_flag 与自旋锁的边界
std::atomic_flag 提供保证 lock-free 的标志操作。test_and_set() 原子地设为 true,并返回原值;clear() 清为 false。以下正确片段只展示锁协议(已包含 <atomic>、<mutex>、<thread>):
| |
使用时用具名 std::lock_guard<SpinLock> 管理,避免异常路径忘记解锁。持锁者被抢占时,等待者仍消耗 CPU;高竞争还会制造缓存一致性流量。单核、过量线程、慢 I/O、长临界区或阻塞操作都不适合这类自旋锁,普通 std::mutex 通常更合适。C++20 的 atomic_flag::test() 可只观察标志;原子等待属于另一种等待实现,应在目标工具链上实际探测支持情况。
9. C++20 的取消与协调工具
9.1 协作式取消:请求、检查、安全退出
取消不是从外部强行截断一条线程。线程可能正在持锁、修改多个字段或管理文件资源,强行终止会留下半完成状态。
C++20 提供一组共享停止状态的句柄:
stop_source:拥有发出停止请求的能力,调用request_stop()。stop_token:观察请求,调用stop_requested();可复制给相关任务。stop_callback:注册请求发生时执行的回调。
jthread 自带停止源。如果线程函数可以接受注入的 token,它会把 token 作为第一个参数传入。请求是一次性的,不能把同一个停止状态重置成“没有请求”;新一轮工作通常需要新状态。
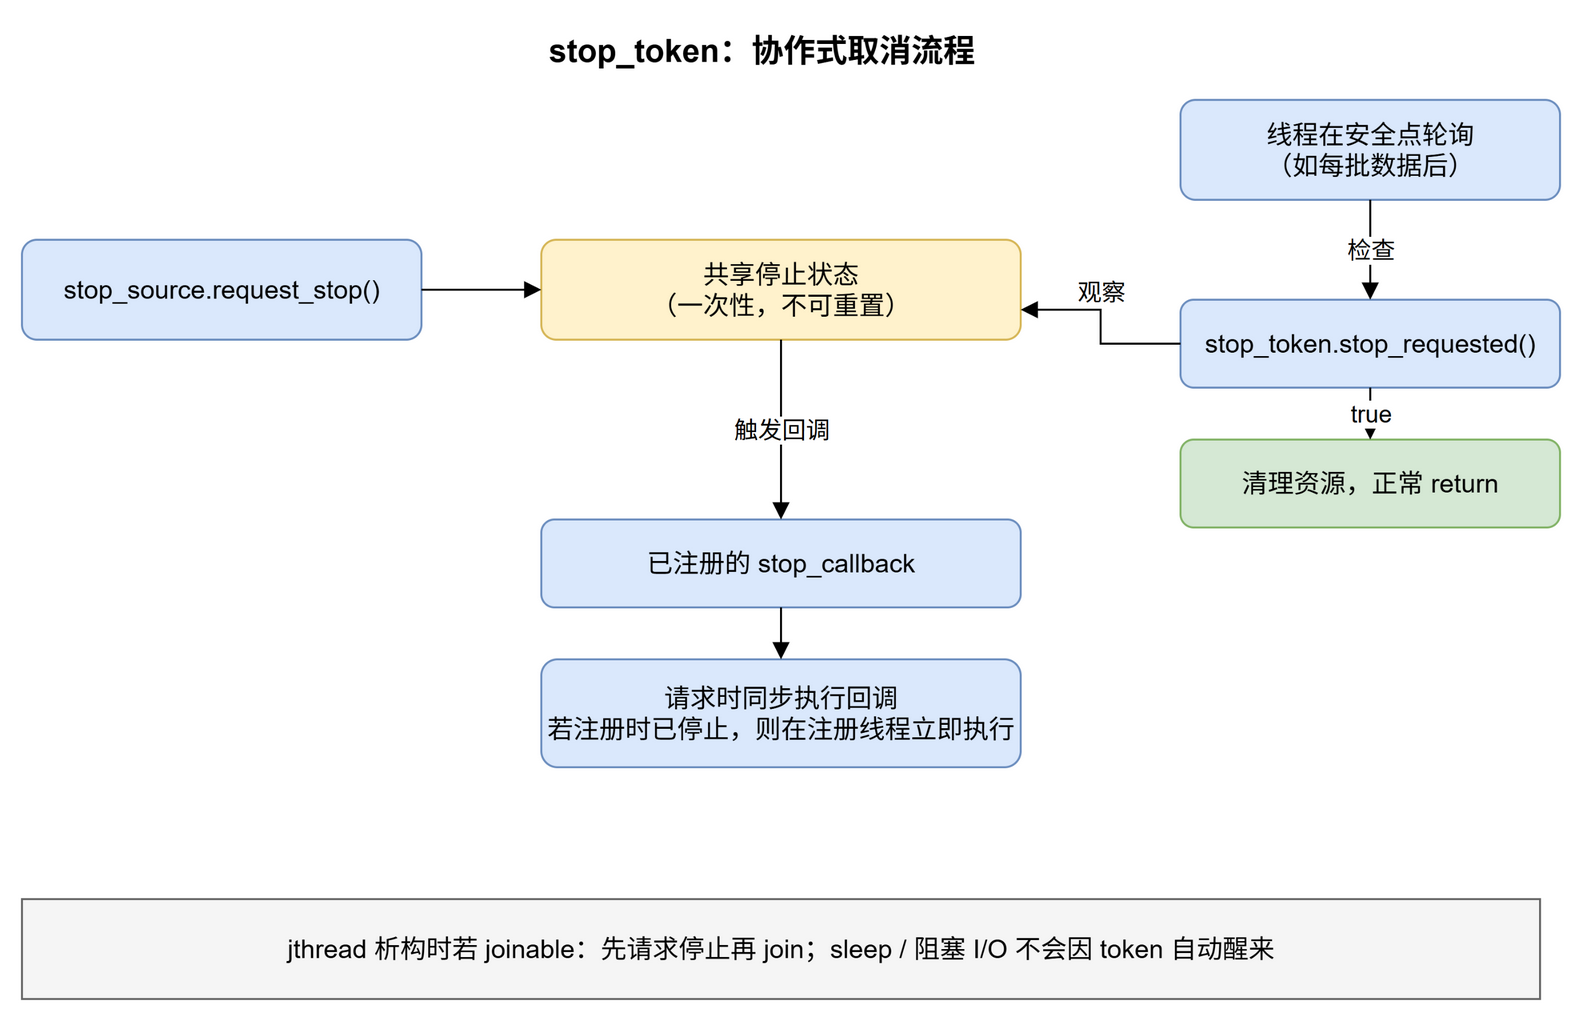
图 9-1:协作式取消的数据流。请求写入共享停止状态;任务在安全点轮询 token,或经 stop_callback 被动响应;两条路径都要求线程自己完成清理后退出。
长计算应在合理的安全点检查 token,例如处理每一批数据后。检查太少影响响应,太频繁也可能增加开销。普通 sleep_for()、阻塞 I/O 和 condition_variable::wait() 不会仅因 token 被请求就自动醒来。
停止句柄的接口一览:
| 接口 | 作用 | 注意事项 |
|---|---|---|
stop_source::request_stop() | 向共享停止状态发出一次停止请求 | 仅当本次调用首次发出请求时返回 true;未关联状态或已请求过返回 false |
stop_source::get_token() | 取得观察该状态的 stop_token | 可复制分发给任意数量的任务或回调 |
stop_token::stop_requested() | 查询关联状态是否已收到停止请求 | 成功返回 true 的 request_stop() 与关联查询返回 true 建立同步;查询 false 不建立这条边,也不保证随后仍无请求 |
stop_token::stop_possible() | 是否已收到请求,或仍可能通过关联 source 收到请求 | 无状态,或者尚未请求且已无关联 stop_source 时为 false;仅有 token 持有状态不够 |
stop_callback<Fn>(token, fn) | 状态被请求时执行一次 fn | 已请求则在注册线程立即执行;否则可能在请求线程中同步执行,见 §9.2 的注意事项 |
停止查询的同步规则见 C++20 停止状态,可行性规则见 stop_token 成员。这不代表查询能保护整个业务事务,也不代表请求后线程已经退出;回收线程仍需 join。
9.2 等待中的线程也必须能退出
condition_variable_any 可配合满足基本加锁要求的锁类型;这里使用它,主要是为了让等待同时响应停止请求。C++20 的三个可中断等待重载如下,stop_token 都紧跟在锁参数后:
| 重载 | 等待边界 |
|---|---|
wait(lock, token, pred) | 条件成立或收到停止请求 |
wait_for(lock, token, rel_time, pred) | 再加相对超时预算 |
wait_until(lock, token, abs_time, pred) | 再加绝对截止时间 |
三者都必须带谓词,不存在不带谓词的 wait(lock, token) 重载。返回值均为返回前谓词的最新求值结果(bool),不是唤醒原因的枚举;返回时重新持有锁。示例 18 用业务状态判断这次应继续工作还是退出。
示例 18:取消正在等待、或者尚未开始等待的线程。
| |
输出 cancelled。work_ready 始终为 false,只有工作线程写 cancelled,主线程 join 后读取。停止请求与谓词同时成立时,等待结果仍根据谓词决定;真实队列必须规定“有任务时先处理”还是“停止优先”,不能从一个 bool 猜出业务策略。可中断等待的定义见 C++20 condition_variable_any。
stop_callback 可能在调用 request_stop() 的线程中同步执行;注册时如果已经请求停止,回调会在注册线程中、注册返回前立即执行。回调对象析构还可能等待另一线程正在执行的该回调;持有回调所需锁时销毁回调也可能死锁。因此回调要短,且绝不能抛出异常(逃出回调的异常会导致 std::terminate()),也不要在持有回调需要的锁时请求停止,否则可能死锁。通常应优先使用上面的标准等待重载,避免自己拼装容易丢通知的回调协议。
jthread 析构会请求停止再等待,但以下情况仍会卡住:函数完全不检查 token;线程等在不支持取消的操作上;退出需要一把当前析构者持有的锁。多个相互依赖的 jthread 通常应先向全部线程请求停止,再逐个 join,而不是指望依次析构自动解决互相等待。
9.3 semaphore:保存许可数量
条件变量通知不积累;信号量保存一个许可计数。acquire() 在计数为零时等待,否则减一;release() 增加许可并使等待者有机会继续。binary_semaphore 适合最多一个许可的交接,counting_semaphore<N> 用于多个许可,N 是所需最大值的下界,不应把它误读为所有实现的精确上限。
信号量没有 mutex 那样的线程所有权,允许一线程 acquire、另一线程 release。它适合限制同时使用某资源的任务数或交付可用项数量;不能自动保护任意容器结构。不得 release 到超过允许的最大计数,等待者也不保证公平;try_acquire() 允许伪失败。
counting_semaphore<N> 的接口一览(binary_semaphore 即 counting_semaphore<1>):
| 接口 | 作用 | 注意事项 |
|---|---|---|
构造函数 counting_semaphore(n) | 以 n 个初始许可创建 | 要求 0 <= n <= max();不可复制、不可移动 |
acquire() | 许可减一;计数为零时阻塞至可用 | 获取观察到某次 release 的效果时建立相应同步;初始许可不对应 release,示例 19 的数据交接依赖后续 release |
try_acquire() | 不阻塞地尝试减一,返回是否成功 | 允许伪失败:即使计数为正也可能返回 false;返回 false 时未取得许可 |
try_acquire_for(d) / try_acquire_until(t) | 在限定时长或时刻内等待许可 | 超时返回 false;超时不是实时返回保证 |
release(update = 1) | 许可增加 update 个 | 前置条件:update >= 0 且释放后计数不超过 max(),违反是未定义行为;任意线程都可释放 |
max()(静态) | 返回实现支持的最大计数 | 至少为模板参数 N;N 只是“最小上限”,实际可以更大 |
示例 19:单槽交接三份数据。该例需要实现了 <semaphore> 的 C++20 标准库。
| |
预期输出 6。两个方向的交接分别防止“未写完就读”和“未读完就覆盖”;计数始终在 0 与 1 之间。一个信号量不够表达这两种所有权转移。多生产者、多消费者队列还涉及槽位索引等共享状态,应另用锁保护。
真实资源许可应使用作用域守卫确保异常时也归还;本例槽中只进行不会抛业务异常的整数操作。标准规则见 C++20 semaphore。
9.4 latch:一次性的完成集合
latch 是倒计数门闩:count_down() 表示完成一份工作且不等待,wait() 等计数归零但不减计数;arrive_and_wait() 则先减计数再等待归零。计数不能重置,归零后等待者通过。不能把计数减到零以下。
latch 的接口一览:
| 接口 | 作用 | 注意事项 |
|---|---|---|
构造函数 latch(n) | 以计数 n 创建 | 要求 0 <= n <= max();一次性,不可重置、不可复制 |
count_down(update = 1) | 计数减 update,不等待 | 各线程在各自 count_down 之前完成的写入,对因计数归零而通过等待的线程可见;前置条件 update >= 0 且不超过当前计数,违反是未定义行为 |
wait() | 阻塞至计数归零 | 不消耗计数;计数已为零时立即通过 |
try_wait() | 非阻塞查询计数是否已归零 | 返回布尔值,不等待;标准允许以极低概率伪失败返回 false |
arrive_and_wait(update = 1) | 先减计数,再等归零 | 等效于 count_down(update) 后接 wait() |
max()(静态) | 返回实现支持的最大计数 | 仅作能力提示 |
示例 20:等待两个结果准备完成。该例需要实现了 <latch> 的 C++20 标准库。
| |
预期输出 42。门闩等待的是某个进度点,不一定是线程退出;所以线程仍然需要回收。本例计数减少后不再修改结果。若某个任务异常退出而没 count_down,等待可能永久持续,必须在应用协议中处理失败。
9.5 barrier:重复进行的阶段边界
barrier 适合参与者固定、工作分轮进行的计算。每个参与者调用 arrive_and_wait(),本阶段参与者都到达后再继续。可以提供不抛异常的完成函数,在阶段切换时执行归并等操作;不要在完成函数中等待需要下一阶段才能完成的工作。
barrier 的接口一览:
| 接口 | 作用 | 注意事项 |
|---|---|---|
构造函数 barrier(n, f) | 以 n 个预期参与者与完成函数 f 创建 | 要求 0 <= n <= max();完成类型须满足 is_nothrow_invocable_v<CompletionFunction&>,lambda 应显式 noexcept;省略为空操作;零参与者对象只能销毁 |
arrive() | 报告到达并减少本阶段预期计数,不等待 | 要求 0 < update <= 本阶段剩余计数;返回到达令牌并标记 [[nodiscard]] |
wait(token) | 等待令牌对应阶段完成 | 令牌必须来自同一 barrier 的当前或紧邻上一阶段 |
arrive_and_wait() | 到达并等待本阶段完成 | 等效于 wait(arrive()),最常用的汇合形式 |
arrive_and_drop() | 到达并减少当前及后续阶段的预期计数 | 后续阶段正式退出,替代“不告而别” |
max()(静态) | 返回实现支持的最大预期计数 | 仅作能力提示 |
示例 21:两个参与者,三轮填充与读取。该例需要实现了 <barrier> 的 C++20 标准库。
| |
预期输出 18。第二次屏障不可随意删除:否则工作线程可能已经写下一轮 values[1],主线程却还在读上一轮,造成数据竞争。屏障的阶段同步与参与者约束见 C++20 协调类型。
arrive() 只报告到达、减少本阶段计数并返回到达令牌,不等其他参与者;随后可做不依赖本阶段完成的工作,再用 wait(std::move(token)) 等该阶段完成。令牌必须来自同一个 barrier 的当前或紧邻上一阶段。arrive_and_wait() 合并这两个步骤。完成函数由标准允许的参与调用线程执行,不能假设固定在主线程;完成步骤结束 strongly happens-before 因本阶段完成而解除阻塞的等待调用返回,因此能安全交付阶段结果。
参与者不能不告而别;后续阶段不再参与时,要按协议使用 arrive_and_drop() 减少当前和后续预期参与数量。停止请求并不会自动把参与者从 barrier 中移除,取消与阶段退出必须一起设计。
9.6 如何选择
| 需求 | 优先考虑 |
|---|---|
| 保护多个字段的共同规则 | mutex 与 RAII 锁 |
| 等“队列非空或关闭”等动态条件 | condition_variable 与共享谓词 |
| 一个任务交付一次结果或异常 | future 与 promise / packaged_task / async |
| 限制同时使用资源的数量 | semaphore |
| 等一组工作达到一次完成点 | latch |
| 每轮等所有参与者到齐 | barrier |
| 请求任务在安全点结束 | stop_token 与明确退出协议 |
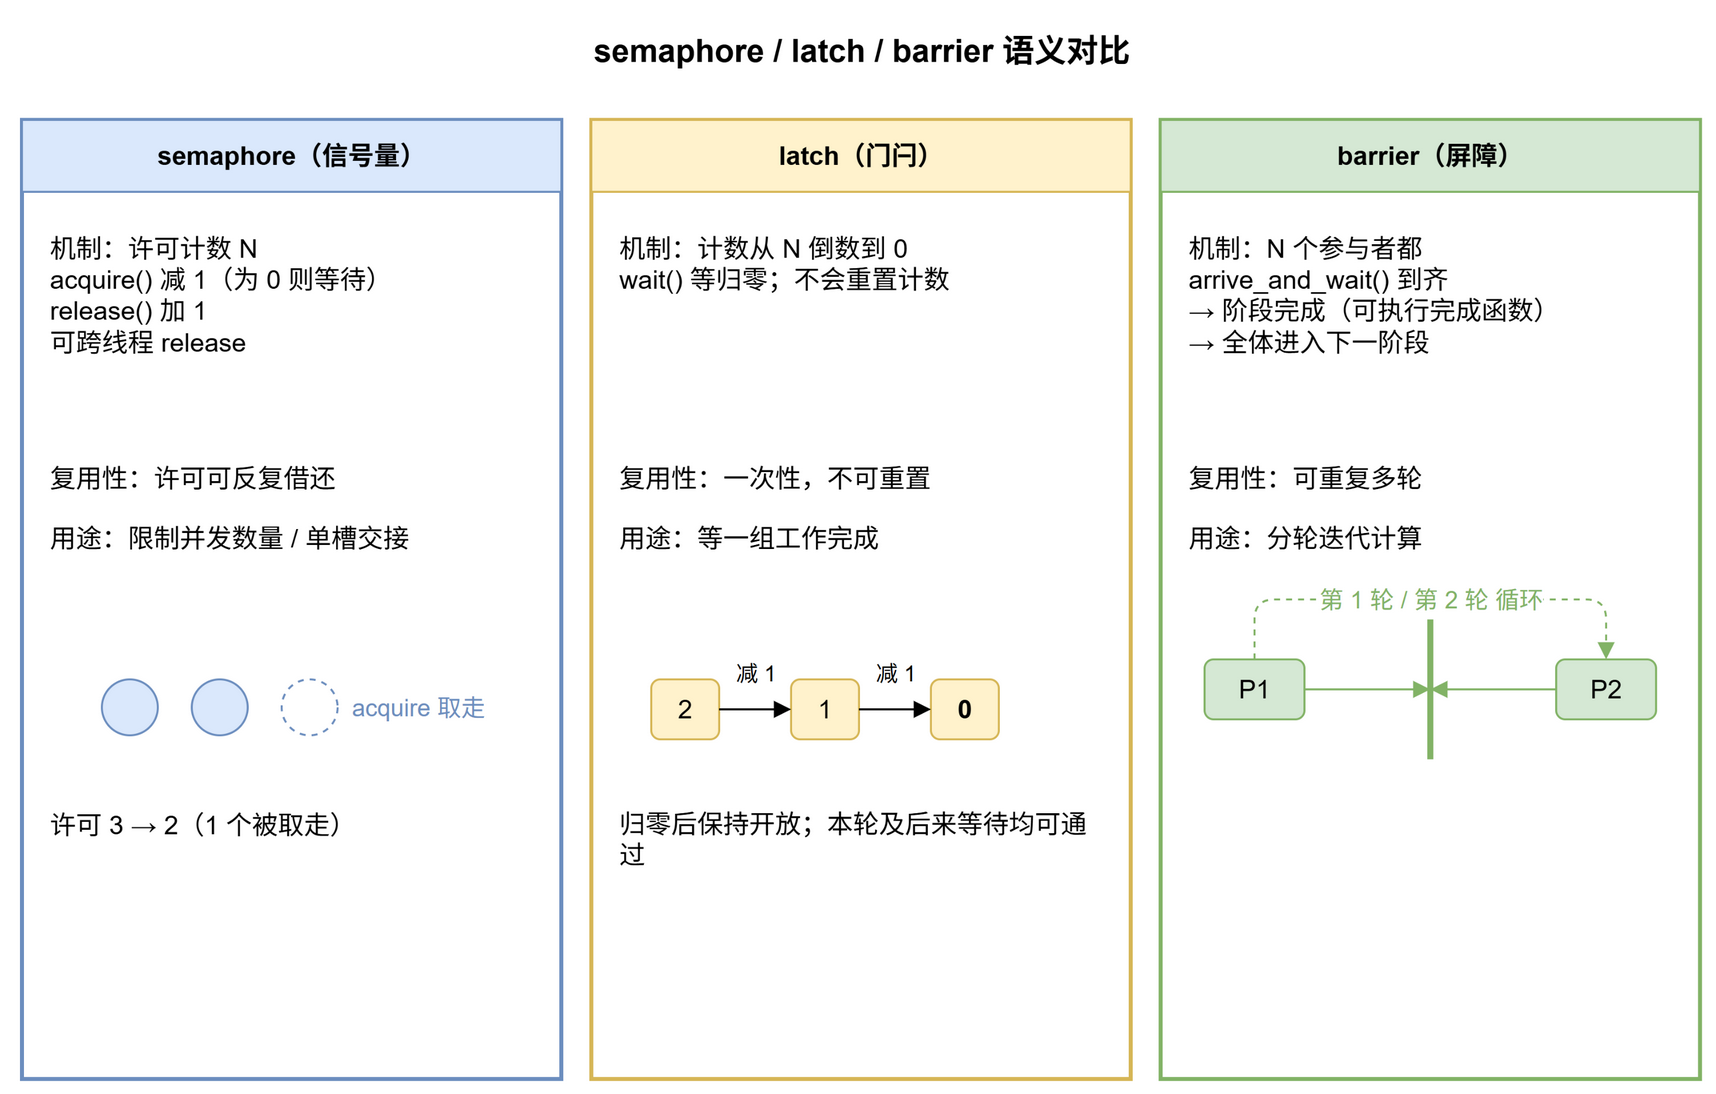
图 9-2:semaphore / latch / barrier 的语义对比——许可计数、一次性倒数、可重复的阶段屏障。
这些工具解决不同问题,不必每个项目都用一遍。
10. 从正确程序走向可维护、可测量的程序
10.1 任务划分比线程数量更重要
先找独立工作,再选执行资源。优先让每个任务只读输入、写自己拥有的输出,最后合并。多个线程修改普通数组的不同元素通常是可行的,但不能同时改变容器结构;vector<bool> 的位打包是一个需要特别警惕的例外。
std::thread::hardware_concurrency() 返回可并发硬件线程数的提示,可能是逻辑核心数,也可能返回 0,且不代表当前可用配额或最佳线程数。需要给 0 设置合理回退值,并限制线程数不超过有意义的任务数量。空任务应直接返回。
需要“每线程各一份”的状态时,thread_local 让每个线程持有变量的独立实例,从源头消除共享:典型用途是每线程的累计器、缓存或随机数引擎。实例随线程退出而销毁。它是避免共享的工具,不是让共享变安全的工具——把 thread_local 对象的指针或引用交给别的线程,仍需另行处理同步与所属线程退出时的寿命。在线程池中,它的寿命按线程而不是任务划分;连续任务会复用同一份状态。上篇示例 5 这种一次性任务用 lambda 内普通局部变量即可;若采用每线程累计器,需要在线程退出前主动把副本交给归并者,主线程不能靠同名 thread_local 变量读取其他线程的实例。
CPU 密集任务可以从与可用硬件资源接近的工作线程数量开始测量;大量阻塞 I/O 可能需要不同策略。C++20 标准库没有通用网络异步 I/O 或现成通用线程池,不能靠无限创建线程解决所有场景。
10.2 为什么多线程可能更慢
| 成本或限制 | 影响 | 常见改进方向 |
|---|---|---|
| 线程创建与回收 | 小任务来不及抵消管理成本 | 复用少量工作线程,批量提交 |
| 上下文切换 | 调度、栈和缓存状态切换有成本 | 控制线程数,避免大量无效唤醒 |
| 锁竞争 | 线程等待同一临界区 | 缩短临界区、局部累计后合并、减少共享 |
| 任务太细 | 入队与同步成本占比过高 | 合并相邻小任务 |
| 任务太粗 | 少数长任务拖住结尾 | 合理分块或动态任务队列 |
| 内存带宽 | 多核心同时读写也可能受带宽限制 | 改善访问方式,避免重复搬运 |
| oversubscription | 活跃线程超过合适资源数,竞争加剧 | 避免嵌套并行层各自创建整组线程 |
**false sharing(伪共享)**是不同线程修改不同变量,但这些变量恰好位于同一缓存行,导致缓存一致性流量增加。它可能没有数据竞争,却影响性能。每线程局部累计、减少写入频率、必要时分隔热点数据都可能有帮助。
**cache locality(缓存局部性)**指近期或相邻数据容易复用。让线程处理连续区间,通常比随机追逐指针更有利于局部性,但具体收益必须测量。盲目填充每个对象会增大内存占用,反而损害局部性;缓存行大小也不能一概假设为 64 字节。
10.3 常见设计模式
| 模式 | 数据与执行怎样组织 | 适合与限制 |
|---|---|---|
| 分块计算后归并 | 每线程处理独立区间,回收后合并 | 输入可拆分,结果可组合;注意负载不均 |
| 生产者—消费者 | 队列连接提交者和处理者 | 需要关闭协议;有界队列还能提供背压 |
| 固定工作线程池 | 少量线程循环取任务 | 避免每任务创建线程;设计清楚关闭与等待依赖 |
| 流水线 | 不同阶段通过队列交接 | 阶段速率不同,必须限制缓冲增长 |
| 单所有者 / 消息传递 | 一条执行路径修改状态,其他人发送消息 | 减少共享写;注意串行阶段成为瓶颈 |
| 不可变快照 | 发布后只读,更新生成新版本 | 读路径简单;仍需安全发布与寿命管理 |
线程池中所有工作线程都在等待同一池里尚未运行的子任务时,会发生资源耗尽式死锁;它不要求出现 mutex。优先在协调者线程等待,或避免这样的嵌套依赖。
背压指处理跟不上时,限制提交速率或队列容量,而不是无限积累任务。§11 的任务处理器输入有限,先用无界队列保持核心协议清楚,再讨论有界扩展。
10.4 std::execution 的边界
C++17 起某些标准算法可接受 std::execution::par 等执行策略,但策略不是“保证使用 N 个核心”的命令。实现可以选择串行执行;并行实现还可能需要额外后端,例如一些 libstdc++ 配置使用 TBB,不能承诺默认编译命令就获得并行执行。本文不涉及后端配置,也不给出并行加速演示。参见 libstdc++ 的执行策略链接依赖。
| 策略 | 用户函数的执行关系 |
|---|---|
std::execution::seq | 在调用线程中执行,各次调用不交错;不承诺某个具体元素顺序 |
std::execution::par | 允许多线程;同一线程内的调用不交错,也可能全部串行执行 |
std::execution::par_unseq | 允许多线程,且同一线程内调用也可不排序、交错执行 |
std::execution::unseq | C++20:在调用线程中允许不排序执行,例如向量化 |
并行调用的回调不能无保护地修改共享状态。par 中可用正确的 mutex 协议保护共享访问,但不能等待“另一个迭代一定会并发执行”,因为实现允许串行。par_unseq 和 unseq 禁止调用向量化不安全的标准库函数,例如 mutex 加锁;同线程交错执行也可能造成死锁。原子操作仍需满足向量化安全要求,不能把任意 atomic 都当作可用的阻塞同步替代品。执行策略规范
对于标准定义的执行策略,算法调用的用户函数如果有异常逃出,标准要求调用 std::terminate();这也包括显式传入 seq 策略的重载,不要把它当作 async 的异常传播模型。算法自身分配资源失败可以抛出 std::bad_alloc,与用户函数逃出的异常要区分。
10.5 怎样验证和测量
正确性检查先于性能测试:先写出所有权、锁保护范围、退出条件,再做小规模确定性结果检查、不同任务数、异常路径和重复运行。日志会改变调度,只能帮助定位,不能证明顺序。
在支持的平台上,可用 ThreadSanitizer 检查部分数据竞争。它不能证明没有逻辑竞态、死锁或悬空生命周期问题;可在受支持的 GCC/Clang 环境单独构建,例如:
| |
这条诊断命令不属于本次已运行的默认编译检查,也不是所有平台都支持;TSan 官方手册建议编译与链接都带上 -fsanitize=thread,并开启优化(-O1/-O2 均可)配合 -g,兼顾运行速度与带行号的报告。不要把检测器下的速度用于性能比较。
测量性能时,用相同输入和优化等级,先比较串行基线;计入或明确排除创建线程、入队、合并成本;使用单调的 steady_clock 测时间间隔;重复测量并观察分布,记录硬件、线程数与负载。不要在被计时的热点中打印日志。本文的示例都不做计时,也不声称实际加速;更多线程并不必然更快。
10.6 并发测试是一组协议
先检查确定性的结果和不变量,再改变 worker、生产者、消费者和任务数量。测试的共享统计也要同步,可让各线程写独占槽位,join 后汇总。用 promise/future、latch 或受锁保护的谓词安排测试进度;sleep_for() 只能扰动调度,不能判断另一个线程已经完成。
压力测试记录随机 seed(种子)和输入,同一 seed 可复现输入,但不能保证复现线程调度。重复 100 次、500 次或更多,只能提高发现缺陷的机会;data race 程序不必输出错误值,relaxed 错误发布也不必在 x86 上失败。内存序必须另写 happens-before 证明。
死锁、未满足 future 和关闭失败要在独立进程中设置 timeout;不要把可能永久阻塞的线程留在评分器进程里。超时报告应区分等待失败与构建失败。覆盖任务异常、空工作、非法输入、重复关闭、重复构造与析构,以及 shutdown 与 submit 同时发生的接受边界。CMake 负责可移植构建,CTest 注册带超时的行为测试,Python 编排编译、重复运行、seed 与评分;断言不是完整评分系统。
工具检测是补充证据。TSan 发现部分 data race;AddressSanitizer 检查部分越界和失效访问。二者应分开构建,先实际探测编译、链接与运行能力,不支持时明确 SKIP。测试通过、检测器无报告与代码正确性证明是三种不同证据。TSan 官方说明
11. 完整示例:可关闭的并发平方任务处理器
11.1 需求与设计约束
本节实现一个小型批处理器:主线程提交整数任务,固定数量工作线程从共享队列取任务,计算平方。每个任务返回独立 future,调用者按提交顺序取得结果。
它需要满足以下要求:
- 每个已接受任务恰好被取走一次;计算在队列锁之外执行。
- 输入只允许 0 到 1000;非法输入通过 future 传播
invalid_argument,不杀死工作线程。 - 主线程提交结束后关闭队列;关闭后不再接受任务,已有任务全部处理完,空队列上的等待者退出。
- 工作线程由
jthread管理。线程创建或提交失败时,也要关闭队列,让已经启动的线程退出后再向上抛出异常。 - 检查空输入、单线程、多线程、合法与非法任务;拒绝零个工作线程。
这里选择排空关闭:关闭只禁止新增任务,仍处理已接受任务。停止时丢弃排队任务属于另一种契约,需要明确被丢弃任务的 future 如何完成,不应混入同一个模糊开关。
11.2 完整实现
示例 22:任务队列与异步结果。
| |
输出 all batch checks passed。run_batch 是阻塞的批处理接口:内部任务并发执行,但函数返回前等待整批结束,所以返回的 futures 已就绪。保留 future 是为了展示每个任务独立保存成功或异常;不能把这个接口称为“立即返回的异步提交服务”。
11.3 设计与线程安全依据
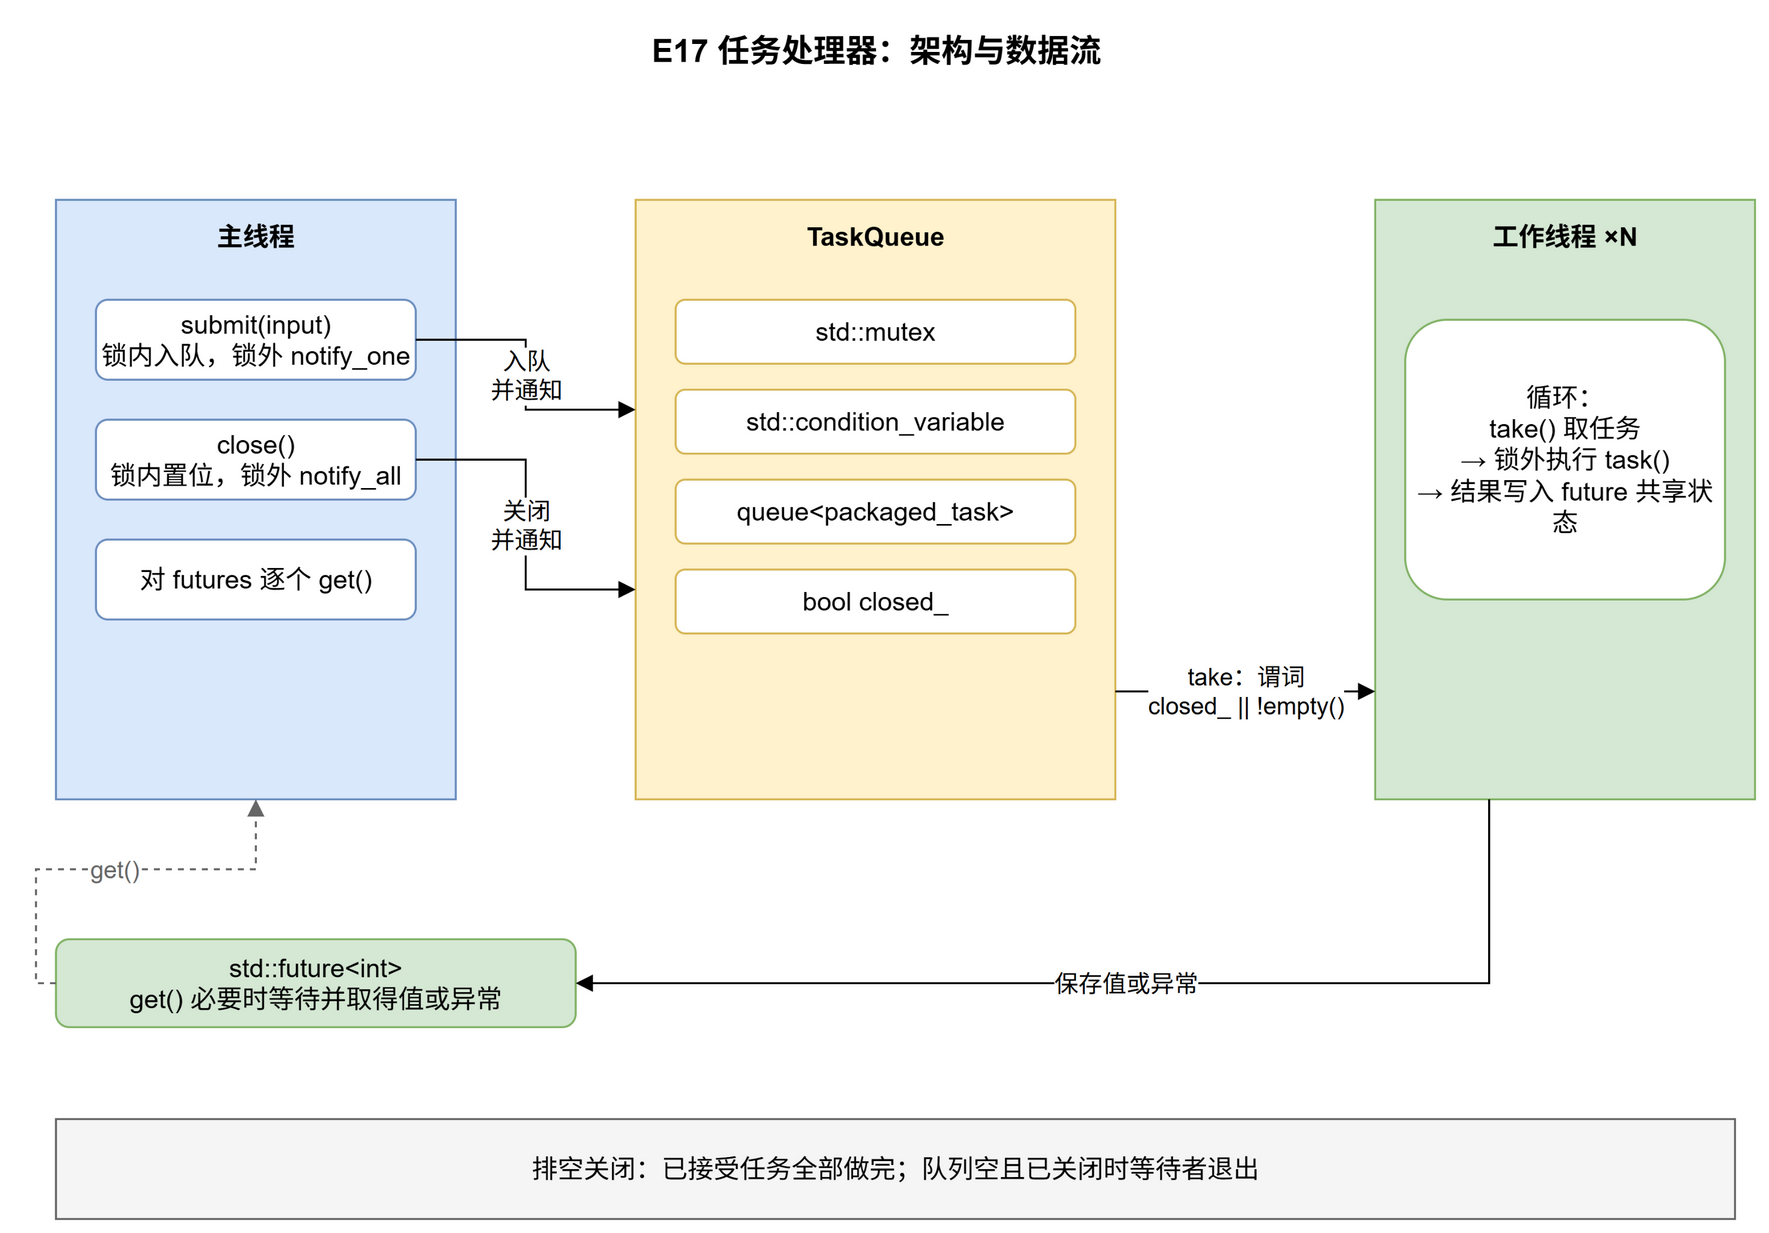
图 11-1:任务处理器的组件与数据流。提交、取任务、关闭三条路径都经过同一把队列锁;计算与结果交付在锁外完成。
所有权:主线程持有结果句柄;队列持有未执行任务;工作线程通过移动取得任务独占执行权。lambda 按值捕获整数,不引用调用者临时输入。packaged_task 不可复制,避免同一个任务被意外复制到两处。
共享状态:只有任务队列和关闭标志需要 mutex。两个状态的每次访问都在同一把锁内。结果状态由 packaged_task/future 协议同步,无需再用队列锁保护结果。
等待与同步:提交在锁内入队,解锁后通知。工作线程在锁内检查谓词,等待时原子地释放锁;重新加锁后才能取任务。关闭标志是持续存在的状态,所以即使 close 发生在线程准备等待之前,它也能在持锁检查时观察到关闭状态;随后排空剩余任务,确认队列为空后退出。任务执行在临界区外,慢任务不会一直占用队列锁。
排空:谓词为真不等于立即退出。只有空队列才返回 false;若已关闭但仍有任务,继续取任务。锁内的移动和 pop 是一次受保护的取走过程,因此同一任务只被交给一个工作线程。
寿命:正常路径显式 join;异常路径先 close,再由 workers 的析构回收线程,最后才销毁 queue。没有在持锁时 join。这里工作线程不接受 stop_token,故 jthread 析构发出的停止请求不影响排空契约;线程退出依赖 queue 的关闭状态。
异常:非法输入由 packaged_task 自动捕获,后续任务仍能执行。线程创建或提交时的分配失败会进入清理路径。本例不尝试从底层同步原语自身失效等严重运行环境错误恢复,也不能保证任意永不返回的用户任务能够被关闭;本例的计算任务是有限步骤的整数操作。
结果顺序:任务完成顺序不确定,但主线程按提交顺序保存并读取 futures,因此输出接口不依赖调度顺序。内部共享状态在队列销毁后仍由 future 持有,get 才取出结果。
11.4 可改进方向
先保留这些正确性依据,再根据真实需求扩展:
- 将无界队列改成有界队列:增加“未满或已关闭”的谓词与相应通知;关闭必须同时唤醒生产者和消费者。
- 需要立即返回的服务时,把队列和工作线程放入长寿命对象,并提供明确的
submit、close、join契约;不要返回引用了已销毁局部队列的线程。 - 添加协作取消时,区分“停止接收并排空”和“取消未执行任务”。后者应定义每个未执行 future 的异常或取消结果,并让长计算在安全点检查停止状态。
- 按任务粒度测量吞吐量与延迟,再决定是否批量入队、减少唤醒、复用结果缓冲区。
长寿命服务还要明确契约:submit 入队与关闭状态切换用同一把锁确定接受边界;关闭前成功入队的任务必须完成,关闭后提交同步拒绝。shutdown() 关闭、唤醒并等待全部 worker;重复及并发 shutdown 需要另行串行化回收,不能对同一 jthread 并发 join。不要在持队列锁时 join。
worker 内调用会等待本 worker 的 shutdown 会自等待;应拒绝这种调用,并说明池中任务不能等待同池尚未运行的子任务。析构由唯一所有者负责,外部 submit/shutdown 调用必须先结束;析构与成员调用并发不受服务协议保护。通用任务可用 packaged_task<int()> 保持本文范围:允许可移动的 callable,值与异常交给 future;排空关闭要求用户任务最终返回,协作取消是另一份契约。
不建议一次性加入优先级、工作窃取和无锁队列;它们都增加需要证明的状态与退出路径。
12. 小结
回顾全系列,编写并发代码时可以对照以下工程实践:
- 优先减少共享可变状态;只读输入、独立输出、最后合并。
- 默认 RAII,适合时使用 jthread;禁止让线程超过被引用对象的寿命。
- 对每组共享数据写明保护它的锁与业务不变量;读操作也要遵守协议。
- 锁管理对象有名字;临界区短但完整;多锁用安全加锁方案;等待任务时不持业务锁。
- 条件变量总是围绕共享谓词设计;关闭先修改状态再通知,最后回收。
- 明确每个异步状态由谁满足、谁 get、何时释放最后引用,异常也必须有接收者。
- 原子默认 seq_cst;削弱内存序前写出同步证明,并确认有实际优化需求。
- 取消覆盖计算与等待路径;不要期待析构、超时或停止请求强行中断工作。
- 限制并发资源和队列增长,避免无界创建线程与嵌套等待。
参考资料
涉及容易混淆的规则时,建议直接核对 C++20 草案:
- Lambda 捕获:值、引用、初始化捕获与当前对象捕获。
- scoped_lock:多锁获取与析构;不要依赖解锁顺序。
- 超时计量:相对超时、时钟建议与返回延迟。
- 可中断等待:stop_token 的参数位置与谓词返回值。
- async:策略、结果、异常与关联线程完成的同步。