
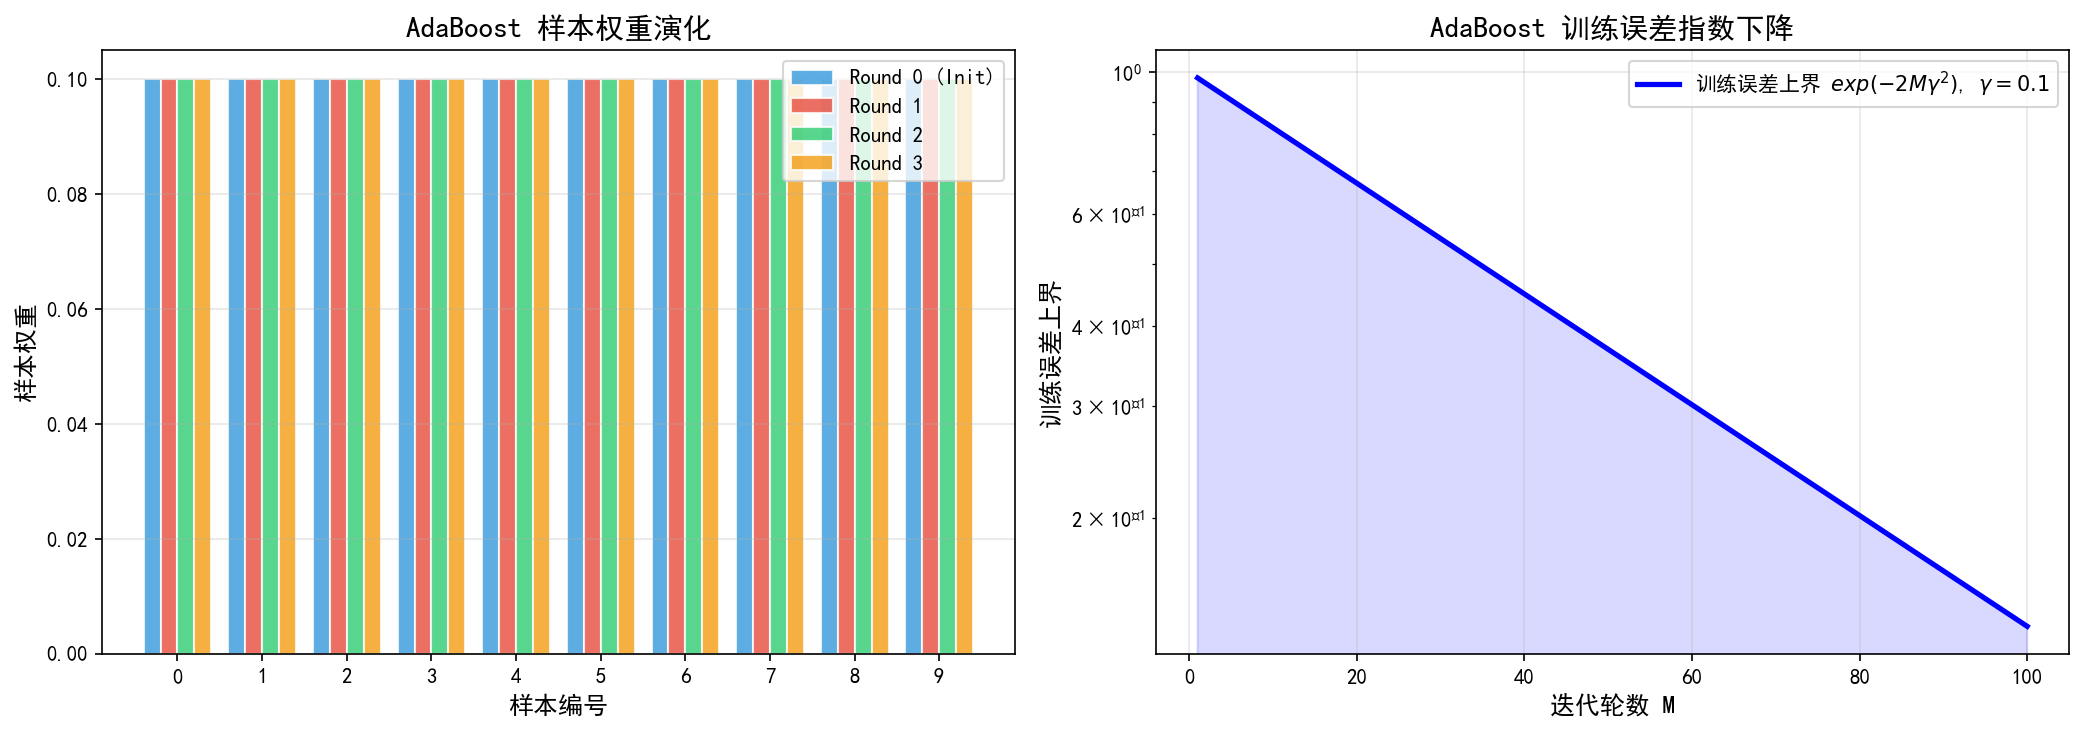
每轮迭代后,错分样本的权重会上升。在满足弱学习条件时,训练误差的上界随迭代下降。
4.1 算法概述与核心思想
AdaBoost(Adaptive Boosting,自适应提升)由 Yoav Freund 和 Robert E. Schapire 于 1995 年首次提出会议版本(EuroCOLT 1995),并于 1997 年在 Journal of Computer and System Sciences 上发表正式论文,是 Boosting 家族中最经典、最具影响力的算法,也是机器学习历史上最重要的算法之一。
AdaBoost 的核心思想可以概括为**“三个臭皮匠,顶个诸葛亮”——通过迭代地训练一系列弱分类器**(weak learners,通常只比随机猜测略好),并自适应地调整训练样本的权重分布,使得后续分类器更关注前面被错分的"困难样本",最终将这些弱分类器按性能加权组合成一个强分类器。
AdaBoost 的迭代逻辑如下:
- 初始化:所有样本被赋予相等的权重,确保第一轮弱分类器在全体数据上学习。
- 迭代训练:每一轮训练一个弱分类器,并根据其加权错误率计算该分类器的"话语权"(权重 $\alpha_m$)。
- 权重更新:增加被错分样本的权重,减少正确分类样本的权重,使下一轮弱分类器聚焦于"还没学好的样本"。
- 加权组合:将所有弱分类器的预测按 $\alpha_m$ 加权投票,得到最终强分类器。
  flowchart TD
    A["初始化样本权重
w_i = 1/N"] --> B["第 m 轮迭代"]
    B --> C["用当前权重训练弱分类器 G_m"]
    C --> D["计算加权错误率 ε_m"]
    D --> E["计算弱分类器权重 α_m"]
    E --> F["更新样本权重
错分样本权重增大"]
    F --> G{"是否达到 M 轮?"}
    G -->|否| B
    G -->|是| H["加权投票组合
G(x) = sign(Σ α_m G_m(x))"]
    H --> I["输出最终强分类器"]
历史意义:Freund & Schapire (1997) 的理论证明——只要每个弱分类器都比随机猜测好出一个固定的优势(错误率 $\leq 1/2 - \gamma$,$\gamma > 0$),AdaBoost 的训练误差将随迭代轮数指数下降(见 4.6 节)。该论文获得了 2003 年哥德尔奖。这一结果在机器学习理论发展史上具有里程碑意义,为 Boosting 方法奠定了坚实的理论基础。
4.2 符号定义表
在深入推导之前,首先统一本文使用的数学符号:
| 符号 | 含义 | 说明 |
|---|---|---|
| $(x_i, y_i), \ i=1,\dots,N$ | 训练样本 | $y_i \in \{-1, +1\}$(二分类标签) |
| $w_i^{(m)}$ | 第 $m$ 轮第 $i$ 个样本的权重 | $w_i^{(m)} > 0$,算法中归一化为 $\sum_i w_i^{(m)} = 1$(4.4、4.7 节推导时使用未归一化的版本,二者只差一个常数因子) |
| $G_m(x)$ | 第 $m$ 轮训练的弱分类器 | 输出 $G_m(x) \in \{-1, +1\}$(硬分类) |
| $\alpha_m$ | 第 $m$ 个弱分类器的组合权重 | 当 $\epsilon_m < 1/2$ 时 $\alpha_m > 0$,错误率越小权重越大 |
| $\epsilon_m$ | 第 $m$ 轮弱分类器的加权错误率 | $\epsilon_m \in [0, 1]$ |
| $M$ | 总迭代轮数(弱分类器数量) | 预设超参数 |
| $G(x)$ | 最终强分类器 | $G(x) = \operatorname{sign}\left(\sum_{m=1}^M \alpha_m G_m(x)\right)$ |
| $f_m(x)$ | 第 $m$ 轮的组合函数(实值输出) | $f_m(x) = \sum_{t=1}^m \alpha_t G_t(x)$ |
| $Z_m$ | 第 $m$ 轮权重归一化因子 | 确保归一化后权重和为 1 |
| $\gamma_m$ | 弱分类器的优势(edge) | $\epsilon_m = \frac{1}{2} - \gamma_m$,$\gamma_m > 0$;注意不要与 4.7 节样本的"间隔(margin)“混淆 |
| $\mathbb{I}(\cdot)$ | 指示函数 | 条件成立时为 1,否则为 0 |
| $K$ | 类别数量 | 多分类扩展时使用 |
约定:本文中弱分类器 $G_m(x)$ 输出离散标签 $\{-1, +1\}$,这种形式称为 Discrete AdaBoost。后续变体(如 Real AdaBoost、SAMME.R)会使用实值或概率输出。
4.3 指数损失函数及为什么适合 AdaBoost
AdaBoost 所优化的目标函数是指数损失函数(Exponential Loss Function),定义如下:
$$L(y, f(x)) = \exp(-y \cdot f(x))$$符号说明:$y \in \{-1, +1\}$ 为真实标签;$f(x)$ 为组合分类器的实值输出。
为什么指数损失适合 AdaBoost?
从分类正确性的角度分析指数损失的行为:
- 当 $y \cdot f(x) > 0$(正确分类):$L < 1$,且 $y \cdot f(x)$ 越大(置信度越高),损失越接近 0。
- 当 $y \cdot f(x) < 0$(错误分类):$L > 1$,且 $y \cdot f(x)$ 越小(错得越离谱),损失指数增长。
- 当 $y \cdot f(x) = 0$(决策边界):$L = 1$。
  graph LR
    subgraph "指数损失函数行为"
        A["y·f(x) > 0"] -->|正确分类| B["损失 < 1
随置信度指数衰减"]
        C["y·f(x) < 0"] -->|错误分类| D["损失 > 1
随错误程度指数增长"]
        E["y·f(x) = 0"] -->|决策边界| F["损失 = 1"]
    end
指数损失与 0-1 损失的关系
AdaBoost 的理论美妙之处在于:指数损失是 0-1 损失函数的上界:
$$\mathbb{I}\left(y f(x) \leq 0\right) \leq \exp\left(-y f(x)\right)$$(当 $y f(x) \leq 0$ 时右侧 $\geq 1$,否则右侧 $> 0$,因此不等式恒成立。)对全部训练样本求和,得到 Freund & Schapire (1997) 训练误差界证明的出发点:
$$\sum_{i=1}^{N} \mathbb{I}\left(y_i f_M(x_i) \leq 0\right) \leq \sum_{i=1}^{N} \exp\left(-y_i f_M(x_i)\right)$$上式左侧是训练集上被错分的样本数(把 $f_M(x_i) = 0$ 的平局也算作错分),右侧是指数损失的总和。因此,逐步最小化右侧的指数损失函数,就同时控制了左侧的训练误差上界。这是 AdaBoost 为什么有效的核心理论依据之一。
  graph TD
    A["最小化指数损失"] --> B["控制 0-1 损失上界"]
    B --> C["训练误差指数下降"]
    C --> D["最终强分类器"]
4.4 弱分类器权重 $\alpha_m$ 的完整推导(4步推导)
AdaBoost 在第 $m$ 轮迭代中,需要选择弱分类器 $G_m$ 和权重 $\alpha_m$ 来最小化当前轮次的指数损失:
$$(\alpha_m, G_m) = \arg\min_{\alpha, G} \sum_{i=1}^{N} w_i^{(m)} \exp(-\alpha \cdot y_i G(x_i))$$其中 $w_i^{(m)} = \exp(-y_i f_{m-1}(x_i))$ 是由前 $m-1$ 轮组合分类器决定的样本权重(即当前目标函数中的权重分布)。它与 $\alpha$、$G$ 无关,在本轮优化中可以看作常数;它与算法中归一化后的权重只差一个正的常数因子,不影响 $\arg\min$ 的结果。
Step 1:按正确/错误分类拆分目标函数
由于 $y_i G(x_i) \in \{-1, +1\}$(两者都是 $\{-1, +1\}$ 标签,相等时为 $+1$,不等时为 $-1$),可将目标函数拆分为:
$$\sum_{i=1}^{N} w_i^{(m)} \exp(-\alpha y_i G(x_i)) = e^{-\alpha} \sum_{y_i = G(x_i)} w_i^{(m)} + e^{+\alpha} \sum_{y_i \neq G(x_i)} w_i^{(m)}$$符号说明:$y_i = G(x_i)$ 表示正确分类的样本集合;$y_i \neq G(x_i)$ 表示错误分类的样本集合。
Step 2:引入权重总和简化表达式
令:
- $W_c = \sum_{y_i = G(x_i)} w_i^{(m)}$(正确分类样本的权重和)
- $W_e = \sum_{y_i \neq G(x_i)} w_i^{(m)}$(错误分类样本的权重和)
- $W_{\text{total}} = W_c + W_e$(总权重和)
则目标函数变为:
$$e^{-\alpha} W_c + e^{+\alpha} W_e = (e^{-\alpha} - e^{+\alpha}) W_c + e^{+\alpha} W_{\text{total}}$$Step 3:最优弱分类器的选择
对于任意固定的 $\alpha > 0$,由于 $e^{-\alpha} < e^{+\alpha}$,上式中 $W_c$ 的系数 $(e^{-\alpha} - e^{+\alpha}) < 0$。因此,最小化整个表达式等价于最大化 $W_c$,即最小化 $W_e$:
$$G_m = \arg\min_{G} \sum_{i=1}^{N} w_i^{(m)} \, \mathbb{I}\left(y_i \neq G(x_i)\right)$$直观理解:在固定 $\alpha$ 的情况下,应该选择使加权错误率最小的弱分类器。这正是 AdaBoost 在每一轮调用 WeakLearn 时传递样本权重 $w_i^{(m)}$ 的原因——让弱学习算法关注权重高的"困难样本”。
Step 4:对 $\alpha$ 求导求解最优权重
将最优弱分类器 $G_m$ 代回目标函数,定义加权错误率:
$$\epsilon_m = \frac{\sum_{i=1}^{N} w_i^{(m)} \, \mathbb{I}\left(y_i \neq G_m(x_i)\right)}{\sum_{i=1}^{N} w_i^{(m)}} = \frac{W_e}{W_{\text{total}}}$$则目标函数可写为:
$$L(\alpha) = W_{\text{total}} \left[ e^{-\alpha}(1 - \epsilon_m) + e^{+\alpha} \epsilon_m \right]$$对 $\alpha$ 求导并令导数为零:
$$\frac{\mathrm{d}L}{\mathrm{d}\alpha} = W_{\text{total}} \left[ -e^{-\alpha}(1 - \epsilon_m) + e^{+\alpha} \epsilon_m \right] = 0$$$$e^{2\alpha} = \frac{1 - \epsilon_m}{\epsilon_m}$$由于 $L(\alpha)$ 是凸函数(二阶导数 $W_{\text{total}}\left[e^{-\alpha}(1-\epsilon_m) + e^{\alpha}\epsilon_m\right] > 0$),这个驻点就是全局最小点。
最终公式:
$$\boxed{\alpha_m = \frac{1}{2} \ln\left(\frac{1 - \epsilon_m}{\epsilon_m}\right)}$$符号说明:$\alpha_m$ 为第 $m$ 轮弱分类器的组合权重;$\epsilon_m$ 为第 $m$ 轮加权错误率;$\ln$ 为自然对数。
直观解释
| $\epsilon_m$ 取值 | $\alpha_m$ 行为 | 含义 |
|---|---|---|
| $\epsilon_m \to 0$(分类极准) | $\alpha_m \to +\infty$ | 该分类器获得极大话语权 |
| $\epsilon_m = 0.1$ | $\alpha_m \approx 1.10$ | 高权重 |
| $\epsilon_m = 0.3$ | $\alpha_m \approx 0.42$ | 中等权重 |
| $\epsilon_m = 0.5$(随机猜测) | $\alpha_m = 0$ | 无话语权,被淘汰 |
| $\epsilon_m > 0.5$(比随机还差) | $\alpha_m < 0$ | 公式上为负权重(相当于把预测反过来用);但标准 AdaBoost.M1 在 $\epsilon_m > 1/2$ 时直接终止(见 4.11 节) |
  graph LR
    subgraph "α_m 随错误率变化"
        A["ε_m → 0"] -->|极准| B["α_m → +∞
极高话语权"]
        C["ε_m = 0.5"] -->|随机| D["α_m = 0
无话语权"]
        E["ε_m > 0.5"] -->|比随机差| F["α_m < 0
反向使用"]
    end
4.5 权重更新公式及行为分析
确定 $G_m$ 和 $\alpha_m$ 后,需要更新样本权重,使下一轮更关注本轮被错分的样本。权重更新规则为:
$$w_i^{(m+1)} = \frac{w_i^{(m)} \cdot \exp\left(-\alpha_m \cdot y_i \cdot G_m(x_i)\right)}{Z_m}$$符号说明:$Z_m$ 为归一化因子,
$$Z_m = \sum_{i=1}^{N} w_i^{(m)} \exp\left(-\alpha_m y_i G_m(x_i)\right)$$它的作用是确保 $\sum_{i=1}^{N} w_i^{(m+1)} = 1$。这里的负号非常重要:正确分类时 $y_iG_m(x_i)=+1$,权重会乘以 $e^{-\alpha_m}$;错误分类时 $y_iG_m(x_i)=-1$,权重会乘以 $e^{+\alpha_m}$。
正确分类 vs 错误分类时的权重变化
由于 $y_i G_m(x_i)$ 的取值取决于分类正确性:
情况一:正确分类($y_i = G_m(x_i)$,即 $y_i G_m(x_i) = +1$)
$$w_i^{(m+1)} = \frac{w_i^{(m)} \cdot e^{-\alpha_m}}{Z_m}$$代入 $\alpha_m = \frac{1}{2} \ln\frac{1 - \epsilon_m}{\epsilon_m}$:
$$e^{-\alpha_m} = \sqrt{\frac{\epsilon_m}{1 - \epsilon_m}} < 1 \quad (\text{当 } \epsilon_m < 0.5 \text{ 时})$$结论:正确分类样本的权重被乘以一个 $< 1$ 的因子,权重减小。
情况二:错误分类($y_i \neq G_m(x_i)$,即 $y_i G_m(x_i) = -1$)
$$w_i^{(m+1)} = \frac{w_i^{(m)} \cdot e^{+\alpha_m}}{Z_m}$$$$e^{+\alpha_m} = \sqrt{\frac{1 - \epsilon_m}{\epsilon_m}} > 1 \quad (\text{当 } \epsilon_m < 0.5 \text{ 时})$$结论:错误分类样本的权重被乘以一个 $> 1$ 的因子,权重增大。
权重更新的倍数关系
错误样本与正确样本的新权重之比为:
$$\frac{w_{\text{错误}}^{(m+1)}}{w_{\text{正确}}^{(m+1)}} = \frac{w_{\text{错误}}^{(m)}}{w_{\text{正确}}^{(m)}} \cdot \frac{1 - \epsilon_m}{\epsilon_m}$$当 $\epsilon_m$ 很小(弱分类器很准)时,比值 $\frac{1 - \epsilon_m}{\epsilon_m}$ 很大,意味着错误样本的权重将被显著放大;反之,当 $\epsilon_m$ 接近 0.5 时,该比值接近 1,权重调整幅度较小。
  graph TD
    subgraph "权重更新机制"
        A["样本 i"] --> B{"G_m(x_i) = y_i?"}
        B -->|正确| C["权重 × e^(-α_m)
权重减小"]
        B -->|错误| D["权重 × e^(+α_m)
权重增大"]
        C --> E["下一轮弱分类器
减少关注"]
        D --> F["下一轮弱分类器
重点学习"]
    end
4.6 最终分类器与训练误差上界(Freund & Schapire 定理)
经过 $M$ 轮迭代后,AdaBoost 的最终强分类器是所有弱分类器的加权投票:
$$G(x) = \operatorname{sign}\left( \sum_{m=1}^{M} \alpha_m G_m(x) \right)$$符号说明:$\operatorname{sign}(z) = +1$ 若 $z > 0$;$\operatorname{sign}(z) = -1$ 若 $z < 0$;$z = 0$ 时可任意指定(通常取 $-1$ 或 $+1$)。
训练误差上界定理
AdaBoost 最引人注目的理论结果是其训练误差的上界。假设每个弱分类器的错误率满足:
$$\epsilon_m \leq \frac{1}{2} - \gamma_m$$其中 $\gamma_m > 0$ 表示该弱分类器比随机猜测好的优势(edge / advantage)。则最终分类器 $G(x)$ 在训练集上的误差满足:
$$\frac{1}{N}\sum_{i=1}^{N} \mathbb{I}\left(G(x_i) \neq y_i\right) \leq \prod_{m=1}^{M} Z_m = \prod_{m=1}^{M} 2\sqrt{\epsilon_m(1-\epsilon_m)} = \prod_{m=1}^{M} \sqrt{1 - 4\gamma_m^2} \leq \exp\left(-2 \sum_{m=1}^{M} \gamma_m^2\right)$$特别地,如果所有弱分类器满足统一优势 $\gamma_m \geq \gamma > 0$(即每个弱分类器至少比随机猜测好 $\gamma$),则:
$$\boxed{\frac{1}{N}\sum_{i=1}^{N} \mathbb{I}\left(G(x_i) \neq y_i\right) \leq \exp\left(-2 M \gamma^2\right)}$$符号说明:$M$ 为迭代轮数;$\gamma$ 为弱分类器的最小优势;$Z_m$ 为 4.5 节中以归一化权重计算的归一化因子。
定理的证明
证明分三步(参见 Freund & Schapire 1997;李航《统计学习方法》第 8.2 节)。
第一步:训练误差 $\leq$ 指数损失。 记 $f(x) = \sum_{m=1}^M \alpha_m G_m(x)$。由 4.3 节的不等式 $\mathbb{I}\left(y f(x) \leq 0\right) \leq e^{-y f(x)}$:
$$\frac{1}{N}\sum_{i=1}^{N} \mathbb{I}\left(G(x_i) \neq y_i\right) \leq \frac{1}{N}\sum_{i=1}^{N} \exp\left(-y_i f(x_i)\right)$$第二步:指数损失 $= \prod_m Z_m$。 从 $w_i^{(1)} = 1/N$ 出发,反复使用更新公式 $w_i^{(m)} e^{-\alpha_m y_i G_m(x_i)} = Z_m w_i^{(m+1)}$:
$$\frac{1}{N}\sum_{i=1}^{N} \exp\left(-\sum_{m=1}^{M} \alpha_m y_i G_m(x_i)\right) = \sum_{i=1}^{N} w_i^{(1)} \prod_{m=1}^{M} e^{-\alpha_m y_i G_m(x_i)} = \left(\prod_{m=1}^{M} Z_m\right) \sum_{i=1}^{N} w_i^{(M+1)} = \prod_{m=1}^{M} Z_m$$第三步:计算 $Z_m$ 并放缩。 由于权重已归一化,
$$Z_m = (1-\epsilon_m) e^{-\alpha_m} + \epsilon_m e^{\alpha_m} = (1-\epsilon_m)\sqrt{\frac{\epsilon_m}{1-\epsilon_m}} + \epsilon_m \sqrt{\frac{1-\epsilon_m}{\epsilon_m}} = 2\sqrt{\epsilon_m(1-\epsilon_m)}$$代入 $\epsilon_m = \frac{1}{2} - \gamma_m$ 得 $Z_m = \sqrt{1 - 4\gamma_m^2}$。再利用 $1 + x \leq e^x$(取 $x = -4\gamma_m^2$),有 $\sqrt{1-4\gamma_m^2} \leq \sqrt{e^{-4\gamma_m^2}} = e^{-2\gamma_m^2}$,连乘即得结论。
第二、三步也说明:AdaBoost 选择的 $\alpha_m$ 恰好是使 $Z_m$ 最小的值,即每一轮都在贪婪地最小化训练误差的上界。
定理的深刻含义
- 指数衰减:训练误差随迭代轮数 $M$ 指数下降。即使 $\gamma$ 很小(如 0.01,即弱分类器准确率仅 51%),只要迭代足够多轮,训练误差也能任意接近于 0。更进一步,训练误差只能取 $0, \frac{1}{N}, \frac{2}{N}, \ldots$ 这些值,所以一旦上界 $e^{-2M\gamma^2} < \frac{1}{N}$,即 $M > \frac{\ln N}{2\gamma^2}$,训练误差就恰好为 0(例如 $N = 1000$、$\gamma = 0.1$ 时,$M > 346$ 即可)。
- 弱学习假设:定理要求每轮的加权错误率都严格小于 $1/2$;要让上界趋于 0,还需要优势 $\gamma_m$ 不能越来越接近 0(例如存在统一的下界 $\gamma$)。注意这里的错误率是在不断变化的加权分布上计算的——随着训练进行,权重集中到困难样本上,弱分类器要维持优势会越来越难,实践中 $\epsilon_m$ 往往逐轮上升并逐渐接近 $1/2$。
- 无需预知优势:与早期 Boosting 算法(Schapire 1990 的递归构造、Freund 的 Boost-by-Majority)不同,AdaBoost 不需要事先知道 $\gamma$;每轮的 $\alpha_m$ 根据实际的 $\epsilon_m$ 自适应确定,这正是 “Adaptive” 的含义。
  graph TD
    A["弱学习假设
ε_m < 0.5"] --> B["每轮获得优势 γ_m > 0"]
    B --> C["训练误差上界
≤ exp(-2Σγ_m²)"]
    C --> D["M 增大 → 误差指数下降"]
    D --> E["最终训练误差 → 0"]
4.7 统计视角:与指数损失最小化的等价性(Friedman et al. 2000)
Friedman, Hastie 和 Tibshirani 在 2000 年的开创性论文 “Additive Logistic Regression: A Statistical View of Boosting” 中,将 AdaBoost 重新解释为统计学中的前向分步加法模型(Forward Stagewise Additive Modeling)最小化指数损失函数。
核心洞见
AdaBoost = 前向分步加法建模 + 指数损失函数
前向分步加法模型
考虑加法模型:
$$f_M(x) = \sum_{m=1}^{M} \beta_m g_m(x)$$符号说明:$g_m(x)$ 为基函数(在 AdaBoost 中即弱分类器 $G_m(x)$);$\beta_m$ 为系数(在 AdaBoost 中即 $\alpha_m$)。
前向分步建模的策略是:在第 $m$ 步,只优化新增基函数的参数,保持前 $m-1$ 步的参数不变:
$$(\beta_m, g_m) = \arg\min_{\beta, g} \sum_{i=1}^{N} L\big(y_i, f_{m-1}(x_i) + \beta g(x_i)\big)$$使用指数损失的等价推导
当 $L(y, f) = \exp(-y f)$ 时,上式变为:
$$(\beta_m, g_m) = \arg\min_{\beta, g} \sum_{i=1}^{N} \exp\big(-y_i f_{m-1}(x_i) - \beta y_i g(x_i)\big)$$令 $w_i^{(m)} = \exp(-y_i f_{m-1}(x_i))$(与 AdaBoost 中定义的权重完全一致),则:
$$= \arg\min_{\beta, g} \sum_{i=1}^{N} w_i^{(m)} \exp(-\beta y_i g(x_i))$$这正是 AdaBoost 在每轮迭代中优化的目标函数! 因此,AdaBoost 的每一步更新等价于对指数损失函数进行坐标下降(coordinate descent)。
总体最小化器与贝叶斯最优分类器
从总体(population)分布的角度看,指数损失函数的总体最小化器是:
$$f^*(x) = \arg\min_{f(x)} \mathbb{E}[\exp(-Y f(x)) \mid X=x] = \frac{1}{2} \log \frac{P(Y=+1 \mid X=x)}{P(Y=-1 \mid X=x)}$$符号说明:$f^*(x)$ 为总体最小化器;$P(Y=+1 \mid X=x)$ 为正类的后验概率;$\log$ 为自然对数。
这是对数几率(log-odds)的一半。贝叶斯最优分类规则与 $f^*(x)$ 的符号一致:
$$\arg\max_y P(Y=y \mid X=x) = \operatorname{sign}\left(f^*(x)\right)$$这说明:通过最小化指数损失,AdaBoost 实际上是在估计类概率的对数几率,进而逼近贝叶斯最优分类器。
重要讨论:统计视角的局限性
Wyner (2003) 在 “On Boosting and the Exponential Loss” 中提出了对统计视角的质疑:任何能够将训练样本完美分类的分类器 $F$(满足 $y_i F(x_i) > 0$),都可以通过乘以一个任意大的正常数来最小化指数损失,但这不改变其分类结果。因此,仅最小化指数损失并不保证泛化性能。
Schapire (2013) 进一步指出,理解 AdaBoost 不仅需要看它在优化什么(指数损失),更要看它是如何优化的(迭代重加权的动态过程、间隔最大化等)。间隔理论(Margin Theory)(Schapire et al., 1998)提供了另一种解释:AdaBoost 通过增加样本的分类间隔(margin)来改进泛化性能,而不只是减少训练误差。
间隔理论(Margin Theory)
实践中经常观察到:AdaBoost 的训练误差降到 0 之后,继续迭代,测试误差仍在下降。只看训练误差或模型复杂度(轮数越多、模型越复杂)都无法解释这一现象。Schapire, Freund, Bartlett & Lee (1998) 用间隔给出了解释。
把组合分类器的输出按权重归一化,定义样本 $(x_i, y_i)$ 的间隔为
$$\operatorname{margin}(x_i, y_i) = \frac{y_i \sum_{m=1}^{M} \alpha_m G_m(x_i)}{\sum_{m=1}^{M} \lvert \alpha_m \rvert} \in [-1, 1]$$间隔为正表示分类正确,其绝对值反映投票的"把握":间隔接近 1 表示几乎所有弱分类器(按权重计)都投了正确的票。
泛化界:设弱分类器所在的假设类 VC 维为 $d$,则以至少 $1-\delta$ 的概率,对所有 $\theta > 0$ 同时有
$$P_{\mathcal{D}}\left[y f(x) \leq 0\right] \leq P_{S}\left[y f(x) \leq \theta\right] + O\left(\sqrt{\frac{d \log^2(N/d)}{N \theta^2} + \frac{\log(1/\delta)}{N}}\right)$$其中 $f$ 为上面归一化后的组合输出,$P_{\mathcal{D}}$ 为真实分布上的概率(即泛化误差),$P_S$ 为训练集上的经验比例。这个界与迭代轮数 $M$ 无关:只要训练集上大部分样本的间隔都较大,泛化误差就有保证。
AdaBoost 会增大间隔:Schapire 等人进一步证明,AdaBoost 训练后间隔不超过 $\theta$ 的训练样本比例满足
$$P_S\left[y f(x) \leq \theta\right] \leq 2^M \prod_{m=1}^{M} \sqrt{\epsilon_m^{1-\theta} (1-\epsilon_m)^{1+\theta}}$$当 $\epsilon_m \leq \frac{1}{2} - \gamma$ 且 $\theta$ 足够小(小于 $\gamma$ 的某个量级)时,右侧随 $M$ 指数下降。$\theta = 0$ 时它退化为上面的训练误差界。也就是说,训练误差降为 0 之后,AdaBoost 还在继续把"刚好分对"的样本推向更大的间隔,这正是测试误差还能继续下降的原因。
争议:间隔理论并非定论。Breiman (1999) 设计的 arc-gv 算法能得到比 AdaBoost 更大的最小间隔,测试误差却更差;Reyzin & Schapire (2006) 指出,这是因为 arc-gv 使用的基学习器更复杂(树更深),并认为应当关注整个间隔分布而不只是最小间隔。
  graph LR
    A["AdaBoost 训练过程"] --> B["训练误差 ↓"]
    A --> C["间隔 Margin ↑"]
    B --> D["指数损失最小化
Friedman et al. 2000"]
    C --> E["泛化性能提升
Schapire et al. 1998"]
    D --> F["统计视角解释"]
    E --> F
4.8 AdaBoost 变体
AdaBoost 家族拥有丰富的变体,针对不同任务类型(多分类、回归)和不同优化策略(实值输出、概率估计、鲁棒性)进行了扩展。
| 变体 | 提出者/年份 | 核心特点 | 适用场景 |
|---|---|---|---|
| AdaBoost.M1 | Freund & Schapire (1997) | 原始多分类扩展,要求 $\epsilon_m < 1/2$ | 多分类,但门槛过高 |
| SAMME | Zhu, Zou, Rosset & Hastie (2009;2006 年技术报告) | 真正的多分类 AdaBoost,$\alpha_m = \log\frac{1-\epsilon_m}{\epsilon_m} + \log(K-1)$ | 多分类($K>2$),只需准确率优于 $1/K$ |
| SAMME.R | Zhu et al.(2006 年技术报告版本) | 使用类概率估计的实值更新,收敛更快 | 需要概率估计的多分类;scikit-learn 已移除 |
| AdaBoost.R2 | Drucker (1997) | 将回归误差归一化后用于权重更新 | 回归任务 |
| Real AdaBoost | Schapire & Singer (1999);Friedman et al. (2000) 给出概率形式 | 弱学习器输出实值置信度 $f_m(x) = \frac{1}{2}\log\frac{p_m(x)}{1-p_m(x)}$ | 弱学习器能给出类概率估计时 |
| Gentle AdaBoost | Friedman et al. (2000) | 使用 Newton 步长优化,更新更平滑 | 噪声数据,更稳定 |
| LogitBoost | Friedman et al. (2000) | 最小化 Bernoulli 对数似然(Logistic 损失),非指数损失 | 需要概率解释的场景 |
| AdaBoost.RT | Shrestha & Solomatine (2006) | 引入阈值将回归误差转换为 0-1 误差 | 回归,直接适配分类 AdaBoost |
| BrownBoost | Freund (2001) | 对噪声更鲁棒,允许训练误差略高于 0 | 含噪声标签数据 |
| RobustBoost | Freund (2009) | 基于 BrownBoost 思想,对标签噪声具有鲁棒性(MATLAB fitcensemble 提供实现) | 含噪声标签 |
SAMME 的核心改进
SAMME(Stagewise Additive Modeling using a Multi-class Exponential loss function)的 $\alpha_m$ 公式增加了 $\log(K-1)$ 项:
$$\alpha_m = \log\left(\frac{1 - \epsilon_m}{\epsilon_m}\right) + \log(K - 1)$$其中 $\epsilon_m$ 为第 $m$ 轮的加权多分类错误率,样本权重更新为 $w_i \leftarrow w_i \exp\left(\alpha_m \mathbb{I}\left(c_i \neq G_m(x_i)\right)\right)$ 后再归一化($c_i$ 为样本 $i$ 的类别),最终分类器为 $G(x) = \arg\max_k \sum_m \alpha_m \mathbb{I}\left(G_m(x) = k\right)$。
关键优势:只有当 $\epsilon_m < 1 - \frac{1}{K}$(即准确率高于随机猜测的 $1/K$)时,$\alpha_m > 0$。因此 SAMME 只要求弱分类器优于随机猜测,而不是原始 AdaBoost.M1 的准确率 $> 1/2$。当 $K = 2$ 时,$\log(K-1) = 0$,$\alpha_m = \ln\frac{1-\epsilon_m}{\epsilon_m}$ 恰为本文 $\frac{1}{2}\ln$ 形式的 2 倍,最终分类器完全相同,SAMME 退化为标准 AdaBoost。
SAMME.R 的实值更新
SAMME.R 使用弱分类器输出的类概率估计 $p_k^{(m)}(x)$ 计算实值更新:
$$h_k^{(m)}(x) = (K-1) \left( \log p_k^{(m)}(x) - \frac{1}{K} \sum_{k'=1}^{K} \log p_{k'}^{(m)}(x) \right)$$符号说明:$h_k^{(m)}(x)$ 为类别 $k$ 在第 $m$ 轮的实值更新;$p_k^{(m)}(x)$ 为第 $m$ 轮弱分类器预测类别 $k$ 的概率。
SAMME.R 在 Zhu et al. 的实验中通常收敛更快,但要求基学习器支持概率估计(predict_proba)。据 scikit-learn 维护者的说明(GitHub issue #26784),SAMME.R 只出现在 2006 年的技术报告版本中,正式发表的期刊版本并未包含,且实现中观察到发散现象;因此 scikit-learn 在 1.4 版弃用、1.6 版移除了 algorithm='SAMME.R',1.8 版又移除了整个 algorithm 参数。
Real AdaBoost:实值输出的 AdaBoost
Discrete AdaBoost 的弱分类器只输出 $\pm 1$。Schapire & Singer (1999) 允许弱学习器输出实值"置信度",Friedman, Hastie & Tibshirani (2000) 给出了基于类概率的版本(Real AdaBoost):
- 初始化 $w_i = 1/N$;
- 对 $m = 1, \ldots, M$:
- 用权重 $w_i$ 训练分类器,得到加权类概率估计 $p_m(x) = \hat{P}_w(y = 1 \mid x) \in (0, 1)$;
- 令 $f_m(x) = \frac{1}{2}\log\frac{p_m(x)}{1 - p_m(x)}$;
- 更新 $w_i \leftarrow w_i \exp\left(-y_i f_m(x_i)\right)$ 并归一化;
- 输出 $G(x) = \operatorname{sign}\left(\sum_{m=1}^M f_m(x)\right)$。
这里 $f_m(x)$ 恰好是在当前加权分布下,逐点最小化 $\mathbb{E}_w\left[e^{-y f(x)} \mid x\right]$ 的解(与 4.7 节总体最小化器的推导相同),因此 Real AdaBoost 同样是指数损失下的前向分步算法。实际使用时 $p_m(x)$ 需要截断到 $[\varepsilon, 1-\varepsilon]$,以免 $f_m(x)$ 发散。
  graph TD
    A["AdaBoost 二分类"] --> B["AdaBoost.M1
多分类扩展"]
    A --> C["SAMME
真正多分类推广"]
    B --> D["ε_m < 1/2 门槛高"]
    C --> E["ε_m > 1/K 即可
K>2时更实用"]
    A --> F["Real AdaBoost
概率估计"]
    A --> G["Gentle AdaBoost
Newton步长"]
    A --> H["LogitBoost
对数似然"]
    A --> I["AdaBoost.R2
回归版本"]
AdaBoost.R2:回归任务的自适应提升
AdaBoost.R2 由 Drucker (1997) 提出,是将 AdaBoost 从分类推广到回归任务的经典方案。其核心思想是:将回归误差归一化后映射为样本权重更新因子,使后续弱学习器聚焦于当前拟合最差的样本。
核心机制
与分类版本使用 0-1 误差不同,AdaBoost.R2 先把每个样本的回归误差归一化到 $[0,1]$,再用这些误差更新样本权重。设第 $m$ 轮弱回归器为 $G_m(x)$,先计算绝对误差:
$$e_i^{(m)} = \lvert y_i - G_m(x_i) \rvert$$再用当前轮的最大误差做归一化:
$$D_i^{(m)} = \frac{e_i^{(m)}}{\max_j e_j^{(m)}}$$其中 $D_i^{(m)} \in [0,1]$。$D_i^{(m)}$ 越接近 0,说明第 $i$ 个样本在当前弱回归器上预测得越好;越接近 1,说明预测误差越大。
scikit-learn 的 AdaBoostRegressor 还支持三种误差形状,它们都基于归一化误差 $D_i^{(m)}$:
loss 参数 | 每个样本的损失 $L_i^{(m)}$ | 直观含义 |
|---|---|---|
'linear' | $L_i^{(m)} = D_i^{(m)}$ | 默认形式,误差按线性比例进入权重更新 |
'square' | $L_i^{(m)} = \left(D_i^{(m)}\right)^2$ | 更强调大误差样本 |
'exponential' | $L_i^{(m)} = 1 - \exp\left(-D_i^{(m)}\right)$ | 用指数变换压缩到 $[0,1)$ |
权重更新规则
先计算当前弱回归器的加权平均损失:
$$\bar{L}^{(m)} = \sum_{i=1}^N w_i^{(m)} L_i^{(m)}$$若 $\bar{L}^{(m)} \geq \frac{1}{2}$,说明当前弱回归器的表现已经不够好,通常停止本轮或停止继续加入该弱回归器。否则定义:
$$\beta_m = \frac{\bar{L}^{(m)}}{1 - \bar{L}^{(m)}}$$由于 $\bar{L}^{(m)} < \frac{1}{2}$,所以 $\beta_m \in (0,1)$。然后更新样本权重:
$$w_i^{(m+1)} = w_i^{(m)} \cdot \beta_m^{1 - L_i^{(m)}}$$最后再归一化,使所有样本权重之和为 1。
这个公式初看有点反直觉,因为它不是直接给大误差样本乘一个大数,而是给小误差样本乘一个更小的数:
- 若样本预测很好,$L_i^{(m)} \approx 0$,则乘子约为 $\beta_m$,权重明显下降;
- 若样本预测很差,$L_i^{(m)} \approx 1$,则乘子约为 $1$,权重基本不降;
- 归一化之后,大误差样本的相对权重就会上升。
弱学习器权重
第 $m$ 个弱回归器在最终预测中的组合权重为:
$$a_m = \ln\left(\frac{1}{\beta_m}\right)$$$\beta_m$ 越小,说明当前弱回归器的加权平均损失越低,因此 $a_m$ 越大,它在最终预测中的影响也越大。
最终预测
AdaBoost.R2 的最终输出是所有弱回归器预测值的加权中位数。下式用 $\operatorname{WeightedMedian}$ 表示“加权中位数”这个算子:
$$G(x) = \operatorname{WeightedMedian}\left(\{G_m(x)\}_{m=1}^M,\ \{a_m\}_{m=1}^M\right)$$其中 $a_m = \ln(1/\beta_m)$。加权中位数的含义是:把 $\{G_m(x)\}$ 从小到大排序,找到第一个使左侧累计权重达到总权重一半的位置。使用中位数而不是简单平均,可以降低单个异常弱回归器预测值对最终结果的影响。
伪代码
- 输入:训练集 $D = \{(x_i, y_i)\}_{i=1}^N, y_i \in \mathbb{R}$,弱回归算法 $\text{WeakRegressor}$,迭代轮数 $M$
- 初始化:$w_i^{(1)} = 1/N, \quad i = 1, \ldots, N$
- For $m = 1, 2, \ldots, M$ do:
- 根据权重 $w_i^{(m)}$ 训练弱回归器 $G_m(x)$
- 计算绝对误差 $e_i^{(m)} = \lvert y_i - G_m(x_i) \rvert$
- 计算归一化误差 $D_i^{(m)} = e_i^{(m)} / \max_j e_j^{(m)}$
- 根据
loss参数把 $D_i^{(m)}$ 转换为 $L_i^{(m)}$ - 计算加权平均损失 $\bar{L}^{(m)} = \sum_i w_i^{(m)} L_i^{(m)}$
- 若 $\bar{L}^{(m)} \geq 1/2$,停止加入当前弱回归器
- 计算 $\beta_m = \bar{L}^{(m)} / (1 - \bar{L}^{(m)})$
- 更新样本权重 $w_i^{(m+1)} = w_i^{(m)} \cdot \beta_m^{1 - L_i^{(m)}}$
- 归一化权重使 $\sum_i w_i^{(m+1)} = 1$
- 输出: $$G(x) = \operatorname{WeightedMedian}\left(\{G_m(x)\},\ \{\ln(1/\beta_m)\}\right)$$
实现细节:scikit-learn 的
AdaBoostRegressor与 Drucker 原文一致,每轮按当前权重对训练集做有放回重采样,再在重采样数据上训练弱回归器,而不是把权重直接传给sample_weight。
与分类 AdaBoost 的对比:分类 AdaBoost 使用指数损失和 0-1 误差,而 AdaBoost.R2 使用相对误差和中位数组合,对回归中的异常值更稳健。scikit-learn 的
AdaBoostRegressor默认使用loss='linear'(基于线性损失),通过loss='square'或loss='exponential'可选不同的误差度量方式。
4.9 优缺点与适用场景
优点
| 优点 | 说明 |
|---|---|
| 理论保证强 | 训练误差随迭代指数下降,只要弱分类器略优于随机猜测 |
| 不易过拟合 | 在低噪声数据上,常观察到训练误差降为 0 后测试误差仍持续下降(间隔理论的解释见 4.7 节);但这不是绝对的,噪声大时仍会过拟合 |
| 无需大量调参 | 弱分类器通常使用决策树桩(depth=1),超参数较少 |
| 自动特征选择 | 权重更新机制隐式关注重要特征和困难样本 |
| 通用性强 | 只要弱学习器支持样本加权(sample_weight),即可与 AdaBoost 结合 |
| 计算高效 | 训练复杂度 $O(M \cdot T_{\text{weak}})$,其中 $M$ 是迭代次数 |
| 可解释性好 | 通过 feature_importances_ 可分析哪些特征最关键 |
缺点
| 缺点 | 说明 |
|---|---|
| 对噪声敏感 | 误标样本会被反复加权,成为"困难样本",导致模型过拟合噪声。Long & Servedio (2010) 进一步证明:任何最小化凸间隔损失的 Boosting 算法(包括 AdaBoost、LogitBoost)都存在这样的数据分布——无噪声时可以完美学习,但只要加入任意小比例的随机标签噪声,性能就会退化到随机猜测 |
| 对异常值敏感 | 错误标签或极端值会严重影响性能 |
| 要求弱分类器优于随机 | 若弱分类器加权错误率 $\geq 1/2$(二分类),$\alpha_m \leq 0$,无法继续提升,AdaBoost.M1 会提前终止;若弱分类器过强(训练误差为 0),则 $\alpha_m \to \infty$,同样无法继续 |
| 多分类扩展非平凡 | 原始 AdaBoost.M1 要求错误率 $< 1/2$,多类时门槛过高 |
| 可能过拟合 | 当弱分类器过于复杂(如深决策树)或迭代次数过多时 |
| 对不平衡数据处理一般 | 可能需要结合 AdaC2 等成本敏感变体 |
| 难以并行化 | 弱分类器必须顺序训练,迭代间有依赖 |
适用场景
- 基线建模:作为快速、有效的基线分类器,快速建立性能基准
- 特征重要性分析:通过
feature_importances_进行特征筛选和解释 - 二分类问题:AdaBoost 在二分类上表现尤为出色
- 中小规模数据集:数据集不太大($< 100{,}000$ 样本)时效果好
- 需要可解释性的场景:决策树桩提供直观的规则组合
- 集成学习对比实验:作为经典 Baseline 与其他集成方法比较
不适用场景
- 高噪声数据集:标签噪声或异常值较多时,AdaBoost 会将噪声样本反复加权
- 大规模数据集:训练时间随迭代线性增长,大数据量下效率不如 XGBoost/LightGBM
- 高维稀疏数据:如文本分类中的 bag-of-words(此时线性模型通常更好)
- 需要概率校准的场景:原始 AdaBoost 输出概率质量不高(SAMME.R 改善此问题)
- 多类别分类(K > 2):建议使用 SAMME 而非原始 AdaBoost.M1
4.10 sklearn API 与关键参数详解
scikit-learn 提供了 AdaBoostClassifier 和 AdaBoostRegressor 两个实现类。
AdaBoostClassifier API
| |
注意:在 scikit-learn 1.2+ 版本中,
base_estimator已重命名为estimator。在较新的 scikit-learn 版本中,AdaBoostClassifier只保留离散的SAMME算法;旧文档或旧代码中的SAMME.R属于已弃用路径,不建议在新项目中继续使用。
关键参数详解
estimator(基学习器)
- 默认值:
DecisionTreeClassifier(max_depth=1)(决策树桩) - 要求:必须支持样本加权(
sample_weight参数)以及classes_和n_classes_属性 - 常用选择:决策树桩、浅层决策树(
max_depth取 2~5)、SVM(线性核) - 建议:默认的树桩通常足够好;增加树的深度可能提高拟合能力但也增加过拟合风险
n_estimators(弱分类器数量)
- 默认值:50
- 作用:设置最大 boosting 迭代次数
- 注意:若某一轮弱分类器在加权训练集上完美拟合(加权错误率为 0),sklearn 会提前停止,此时
len(clf.estimators_)可能小于n_estimators。除此之外不会基于验证集自动早停,需要借助staged_predict/staged_score自行选择轮数 - 调参建议:
- 小数据集($<1000$):50~100
- 中等数据集:100~500
- 与
learning_rate联合调参:较小的learning_rate需要更大的n_estimators
learning_rate(学习率)
- 默认值:1.0
- 作用:每个弱分类器的权重缩减系数。在 sklearn 中,每轮的分类器权重变为 $\eta\,\alpha_m$,其中 $\eta$ 表示
learning_rate,并且样本权重的更新也使用缩减后的 $\eta\,\alpha_m$: $$w_i \leftarrow w_i \exp\left(\eta\,\alpha_m \mathbb{I}\left(y_i \neq G_m(x_i)\right)\right), \qquad G(x) = \arg\max_k \sum_m \eta\,\alpha_m \mathbb{I}\left(G_m(x) = k\right)$$ (sklearn 实现的是 SAMME,$\alpha_m$ 按 SAMME 公式计算。)注意:如果只在最终投票时把所有权重同乘 $\eta$,预测结果不会有任何变化;learning_rate之所以起作用,是因为它让每轮的样本重加权变得更温和,从而改变了后续弱分类器的训练。 - 物理意义:相当于梯度下降中的步长。较小的学习率使每一步更保守,需要更多迭代
- 调参建议:
- 默认 1.0 通常可行
- 若发现过拟合,可尝试减小到 0.1~0.5,同时增加
n_estimators - 经验法则:
learning_rate和n_estimators存在 trade-off。若记学习率为 $\eta$、迭代轮数为 $M$,常见经验是: $$\eta \times M \approx \text{const}$$
algorithm(算法类型,已移除)
| 版本 | 状态 |
|---|---|
| 1.3 及以前 | algorithm 可取 'SAMME' 或 'SAMME.R'(默认 'SAMME.R') |
| 1.4 | 'SAMME.R' 被弃用 |
| 1.6 | 'SAMME.R' 被移除,algorithm 参数本身被弃用(只剩 'SAMME') |
| 1.8 及以后 | algorithm 参数被移除;传入该参数会抛出 TypeError |
- 实践建议:新代码不要再传
algorithm参数,AdaBoostClassifier默认就是 SAMME。维护旧代码时如果遇到SAMME.R,迁移后需用验证集重新确认指标(SAMME 与 SAMME.R 的结果可能有明显差异)。
AdaBoostRegressor API(回归特有)
| |
loss 参数(回归特有):
| 损失类型 | 公式 | 特点 |
|---|---|---|
'linear' | $L_i = D_i$ | 默认,误差按线性比例进入权重更新 |
'square' | $L_i = D_i^2$ | 更强调大误差样本 |
'exponential' | $L_i = 1 - \exp(-D_i)$ | 有界,对大误差的增长比 'linear' 更平缓 |
其中 $D_i = \lvert y_i - G_m(x_i) \rvert / \max_j \lvert y_j - G_m(x_j) \rvert \in [0, 1]$ 为 4.8 节定义的归一化误差,三种损失都作用在 $D_i$ 上,而不是原始误差 $\lvert y - f \rvert$ 上。
重要属性
| 属性 | 说明 |
|---|---|
estimators_ | 拟合的弱分类器列表 |
estimator_weights_ | 每个弱分类器的权重(SAMME 公式,已乘 learning_rate;二分类时是本文 $\alpha_m$ 的 2 倍) |
estimator_errors_ | 每个弱分类器的加权错误率 $\epsilon_m$(回归器中为加权平均损失 $\bar{L}^{(m)}$) |
feature_importances_ | 特征重要性:各基学习器基于不纯度的特征重要性,按 estimator_weights_ 加权平均 |
classes_ | 类别标签 |
n_classes_ | 类别数量 |
4.11 伪代码
算法: AdaBoost (Discrete AdaBoost / AdaBoost.M1)
- 输入:训练集 $D = \{(x_i, y_i)\}_{i=1}^N, y_i \in \{-1, +1\}$,弱学习算法 $\text{WeakLearn}$,迭代轮数 $M$
- 初始化:$w_i^{(1)} = 1/N, \quad i = 1, \ldots, N$
- For $m = 1, 2, \ldots, M$ do:
- 归一化权重:$p_i = w_i^{(m)} / \sum_j w_j^{(m)}$
- 调用 $\text{WeakLearn}$,提供分布 $p$,得到弱分类器 $G_m(x)$
- 计算加权错误率: $$\epsilon_m = \sum_{i=1}^N p_i \, \mathbb{I}\left(y_i \neq G_m(x_i)\right)$$
- 若 $\epsilon_m > 1/2$,终止(弱学习器不够好)
- 计算弱分类器权重: $$\alpha_m = \frac{1}{2} \ln\left(\frac{1 - \epsilon_m}{\epsilon_m}\right)$$
- 更新样本权重: $$w_i^{(m+1)} = w_i^{(m)} \cdot \exp\left(-\alpha_m \cdot y_i \cdot G_m(x_i)\right)$$
- 归一化权重使 $\sum_i w_i^{(m+1)} = 1$
- 输出最终分类器: $$G(x) = \operatorname{sign}\left(\sum_{m=1}^M \alpha_m G_m(x)\right)$$
4.12 Python 从零实现(逐行详细注释)
| |
4.13 sklearn 使用示例与调参代码
| |