
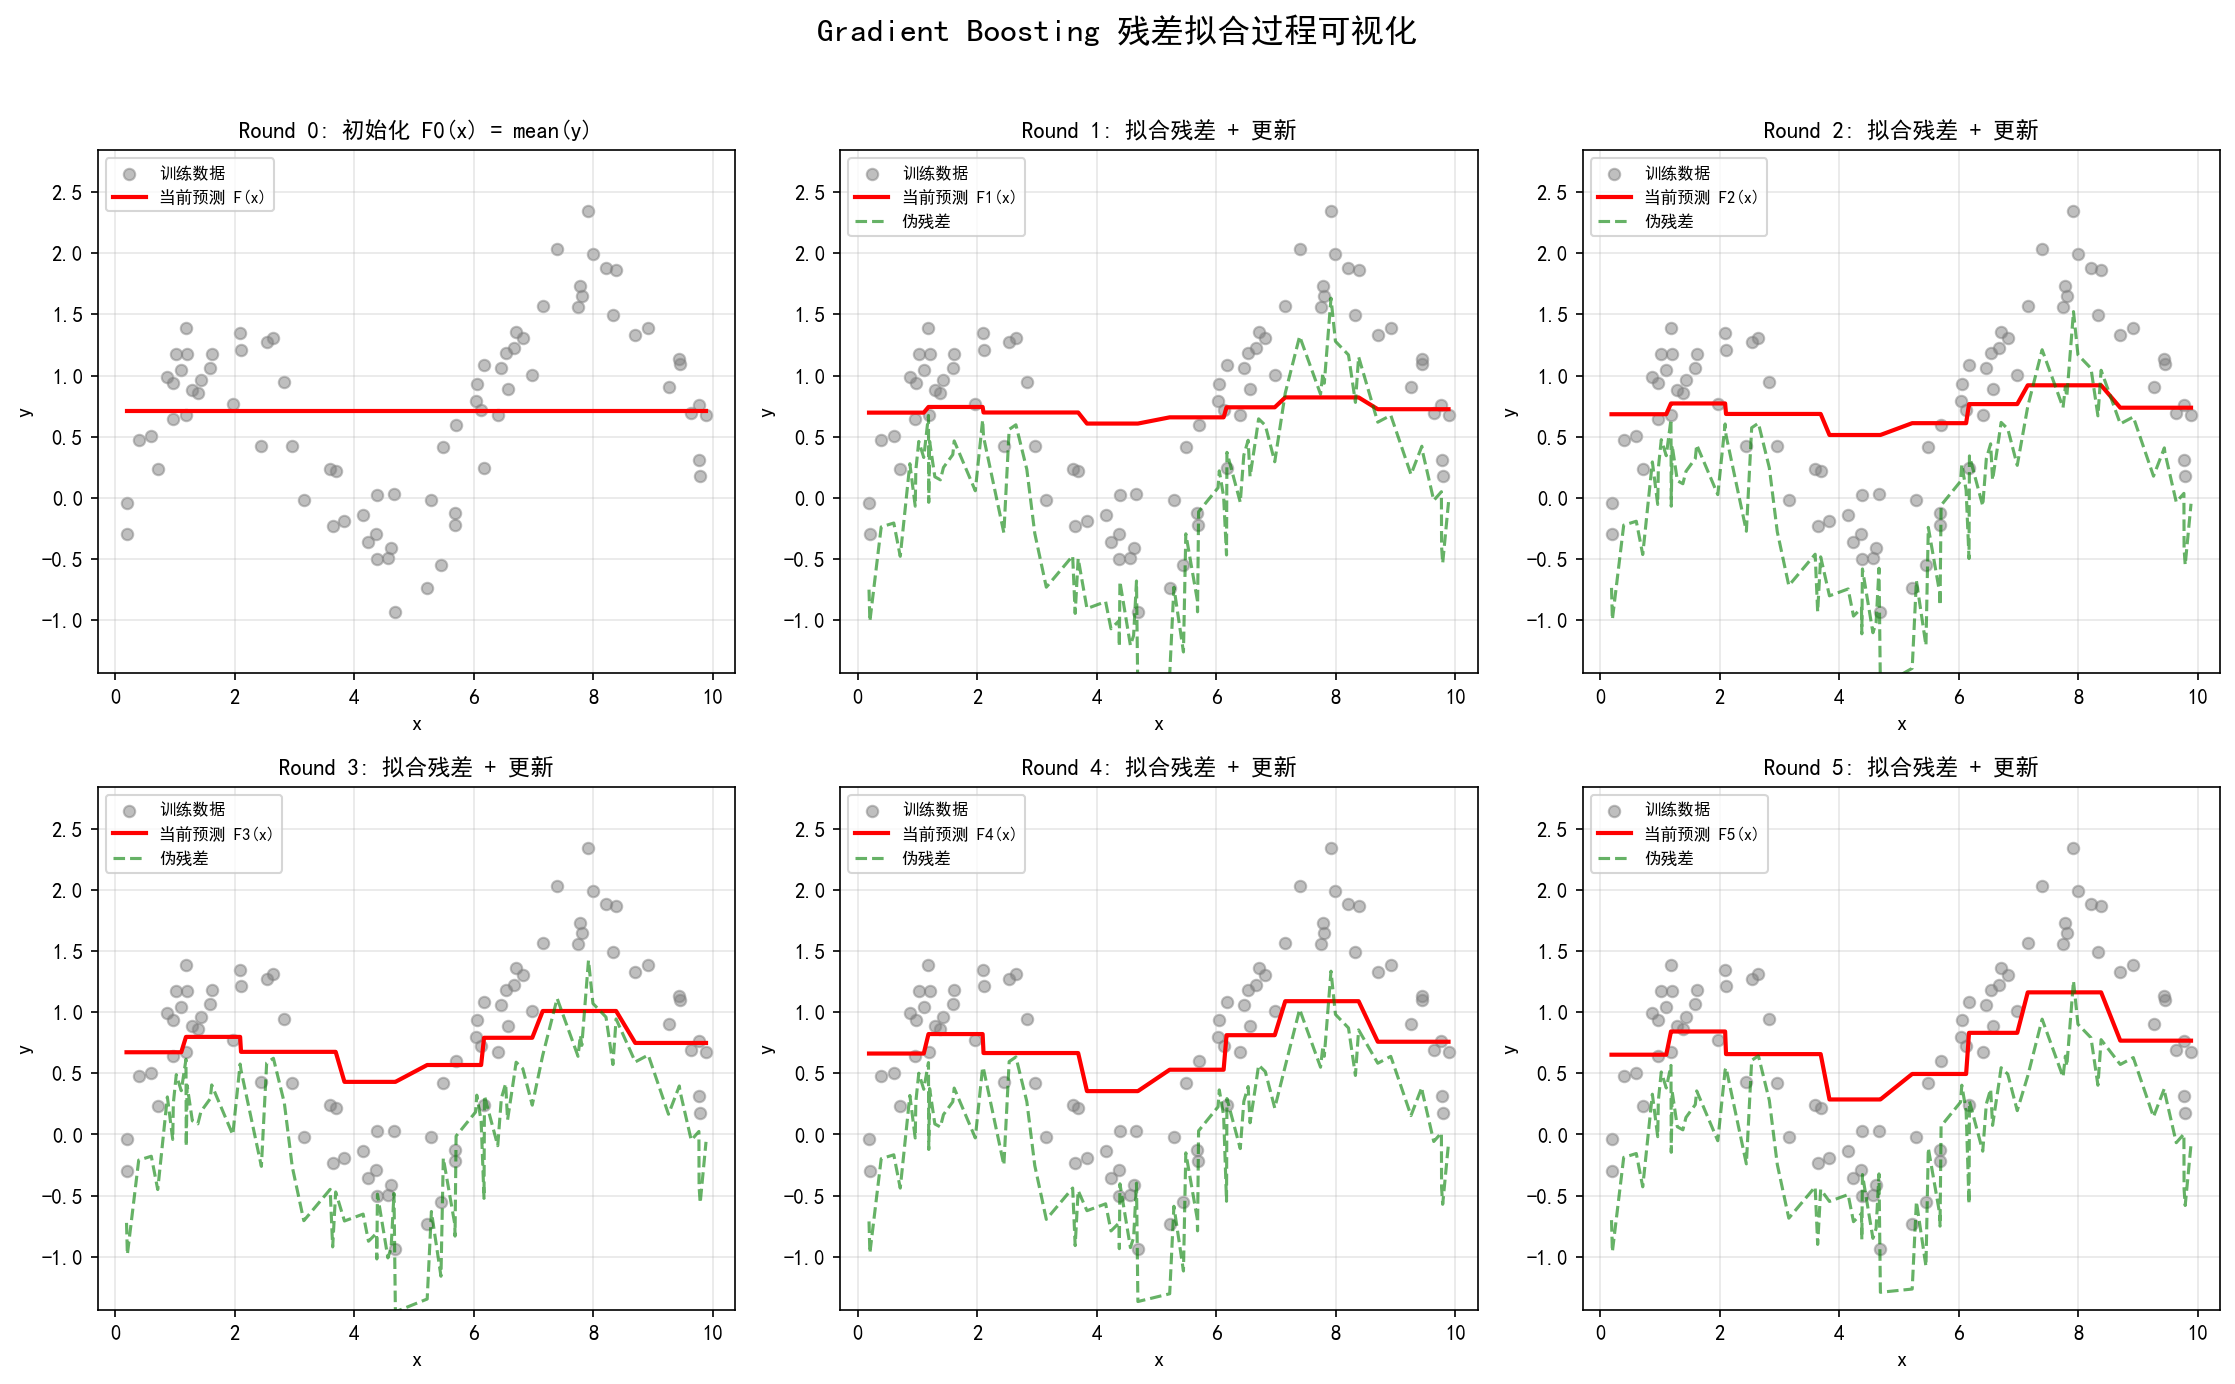
使用平方误差损失时,每一轮的新树拟合当前残差,再按学习率缩放后加入集成。
5.1 函数空间梯度下降的核心思想(Friedman 2001)
Gradient Boosting 的核心思想由 Jerome H. Friedman 在 2001 年的经典论文 “Greedy Function Approximation: A Gradient Boosting Machine” 中提出(1999 年以技术报告形式发布),将 Boosting 框架重新解释为函数空间中的梯度下降(Gradient Descent in Function Space)。这是 Boosting 理论发展史上的又一次重大突破,将 AdaBoost 从特定算法提升为通用的函数优化框架。
给定训练集 $\{(x_i, y_i)\}_{i=1}^n$,目标是最小化一个可微损失函数:
$$\mathcal{L}(F) = \sum_{i=1}^{n} L\big(y_i, F(x_i)\big)$$符号说明:$F(x)$ 是从输入到预测的函数映射;$L(y, F)$ 为损失函数;$n$ 为训练样本数。
传统的梯度下降在参数空间中进行(如神经网络的权重参数),而 Gradient Boosting 将 $F(x)$ 本身视为优化对象——即函数空间梯度下降。在迭代 $m$ 步时,当前模型为 $F_{m-1}(x)$,根据梯度下降原理,更新方向应沿损失函数对当前预测的负梯度方向:
$$F_m(x) = F_{m-1}(x) - \rho_m \left. \frac{\partial L(y, F(x))}{\partial F(x)} \right|_{F=F_{m-1}}$$符号说明:$\rho_m$ 为步长(由线搜索确定);$\frac{\partial L}{\partial F}$ 为损失函数对当前函数值预测的偏导数。
严格地说,上式只在训练点 $x_1, \ldots, x_n$ 上有定义:把 $\left(F(x_1), \ldots, F(x_n)\right)$ 看作一个 $n$ 维向量,负梯度就是 $n$ 维向量 $\left(r_{1m}, \ldots, r_{nm}\right)$(见 5.2 节)。这样的"梯度下降"只能更新训练样本上的预测值,无法推广到新样本。
关键洞察:由于 $F$ 是任意函数,而负梯度只在训练点上已知,我们无法直接在连续函数空间中操作。Friedman 的突破性方法是:用一个弱学习器(通常是浅层决策树)$h_m(x)$ 来近似这个负梯度方向,从而将函数空间中的梯度下降转化为可计算的序列模型。每一棵新树被训练来拟合当前模型的"负梯度",然后将树的预测以学习率为权重加入模型。
  graph TD
    A["传统梯度下降
参数空间"] --> B["更新模型参数 θ"]
    C["函数空间梯度下降
Friedman 2001"] --> D["更新函数 F(x) 本身"]
    D --> E["用弱学习器 h_m(x)
近似负梯度方向"]
    E --> F["累加更新
旧模型加上新弱学习器"]
5.2 伪残差(Pseudo-residuals)的概念
定义在迭代 $m$ 时,样本 $i$ 的伪残差(pseudo-residual)为:
$$r_{im} = -\left[ \frac{\partial L(y_i, F(x_i))}{\partial F(x_i)} \right]_{F=F_{m-1}}$$符号说明:$r_{im}$ 为第 $m$ 轮第 $i$ 个样本的伪残差;$F_{m-1}(x_i)$ 为当前模型对样本 $i$ 的预测值。
“伪残差"名称的由来
- “残差”(residual):对于平方损失 $L(y, F) = \frac{1}{2}(y - F)^2$,该式恰好退化为普通残差 $y_i - F_{m-1}(x_i)$,即观测值与预测值之差。
- “伪”(pseudo):对于一般损失函数,它不再是观测值与预测值之差,而是损失函数对预测值的负梯度。它只在平方损失下恰好等于普通残差,因此冠以"伪"字。
伪残差代表了在当前预测点处,使损失下降最快的方向。每个新弱学习器被训练来拟合这些伪残差,从而将整体模型推向损失更小的区域。从几何角度看,Gradient Boosting 的每一步都是在当前函数值的"切平面"上沿最速下降方向走一步。
  graph LR
    A["当前模型"] --> B["计算伪残差
负梯度方向"]
    B --> C["训练弱学习器 h_m(x)
拟合伪残差"]
    C --> D["更新模型
旧模型加上新弱学习器"]
    D --> E["损失函数减小"]
5.3 泰勒展开解释(一阶梯度下降)
Gradient Boosting 可视为对损失函数进行一阶泰勒展开后的贪心优化。
设当前模型预测为 $F_{m-1}(x_i)$,新增一个弱学习器 $h_m(x_i)$,则新预测为 $F_{m-1}(x_i) + h_m(x_i)$。对损失函数在 $F_{m-1}$ 处做一阶泰勒展开:
$$L\big(y_i, F_{m-1}(x_i) + h_m(x_i)\big) \approx L\big(y_i, F_{m-1}(x_i)\big) + h_m(x_i) \cdot \left. \frac{\partial L}{\partial F} \right|_{F_{m-1}}$$符号说明:$h_m(x_i)$ 为第 $m$ 个弱学习器对样本 $i$ 的预测值;$\frac{\partial L}{\partial F}$ 为损失函数对当前预测值的偏导数。
将伪残差代入:
$$L\big(y_i, F_{m-1}(x_i) + h_m(x_i)\big) \approx L\big(y_i, F_{m-1}(x_i)\big) - h_m(x_i) \cdot r_{im}$$要让近似后的损失下降,应让 $\sum_i h_m(x_i)\, r_{im}$ 尽可能大,即 $h_m$ 在训练点上的取值与伪残差向量方向一致。但一阶近似只在 $h_m$ 很小时成立,单纯追求内积变大会把 $h_m$ 的幅度推向无穷。因此 Gradient Boosting 把问题拆成两步:先选方向——在弱学习器类中找与负梯度最"平行"的函数,Friedman (2001) 用最小二乘实现这一点;再定步长——通过线搜索(或逐叶子优化,见 5.4 节)确定走多远:
$$h_m(x) = \arg\min_{h} \sum_{i=1}^{n} \big(r_{im} - h(x_i)\big)^2$$符号说明:$h_m(x)$ 为拟合伪残差的最优弱学习器;$r_{im}$ 为第 $m$ 轮第 $i$ 个样本的伪残差。
这正是 Gradient Boosting 每一步的核心操作:训练一棵回归树去拟合当前模型的伪残差。由于回归树将特征空间划分为若干叶子区域,在每个叶子内输出常数预测值,因此它提供了一种灵活而高效的方式来近似任意负梯度方向。
5.4 任意可微损失函数的统一框架
Friedman (2001) 的核心贡献之一是将 Boosting 从 AdaBoost 的指数损失推广到任意可微损失函数的统一框架。这是 Gradient Boosting 比 AdaBoost 更具通用性的根本原因。
| 任务类型 | 常用损失函数 | 伪残差形式 | 应用场景 |
|---|---|---|---|
| 回归 | 平方损失 $\frac{1}{2}(y - F)^2$ | $y - F$(普通残差) | 一般回归问题 |
| 回归 | 绝对损失 $\lvert y - F \rvert$ | $\operatorname{sign}(y - F)$ | 含异常值的回归 |
| 回归 | Huber 损失 | $y - F$(当 $\lvert y-F \rvert \leq \delta$);$\delta \operatorname{sign}(y-F)$(否则) | 噪声鲁棒回归 |
| 回归 | 分位数损失(Quantile) | $\tau - \mathbb{I}(y < F)$,即 $y > F$ 时为 $\tau$,$y < F$ 时为 $\tau - 1$ | 预测区间、不确定性估计 |
| 二分类 | 对数损失(Logistic Loss),$y \in \{0,1\}$ | $y - \sigma(F)$ | 二分类问题 |
| 多分类 | 多项式偏差(Multinomial Deviance) | $y_{ik} - p_{k}(x_i)$ | K 类分类问题 |
| 排序 | 成对排序损失 | 依具体定义 | 学习排序(Learning to Rank) |
统一算法框架:
- 初始化:$F_0(x) = \arg\min_\gamma \sum_i L(y_i, \gamma)$
- 对于 $m = 1, \dots, M$:
- 计算伪残差:$r_{im} = -\left[\frac{\partial L}{\partial F}\right]_{F_{m-1}}$
- 拟合弱学习器:$h_m(x) = \arg\min_{h} \sum_i \big(r_{im} - h(x_i)\big)^2$
- 线搜索求最优步长:$\rho_m = \arg\min_\rho \sum_i L\big(y_i, F_{m-1}(x_i) + \rho h_m(x_i)\big)$
- 更新模型:$F_m(x) = F_{m-1}(x) + \nu \cdot \rho_m h_m(x)$
- 输出:最终模型 $F_M(x)$
符号说明:$\nu$ 为学习率(shrinkage);$\rho_m$ 为线搜索最优步长;$M$ 为总迭代次数。
TreeBoost:逐叶子线搜索。当基学习器是含 $J$ 个叶子的回归树时,$h_m(x) = \sum_{j=1}^{J} b_{jm} \mathbb{I}(x \in R_{jm})$ 本身就是 $J$ 个"基函数"的组合。Friedman (2001) 建议不用一个全局步长 $\rho_m$,而是对每个叶子区域分别做线搜索:
$$\gamma_{jm} = \arg\min_{\gamma} \sum_{x_i \in R_{jm}} L\left(y_i, F_{m-1}(x_i) + \gamma\right)$$然后更新 $F_m(x) = F_{m-1}(x) + \nu \sum_{j=1}^{J} \gamma_{jm} \mathbb{I}(x \in R_{jm})$。也就是说,树只用来确定如何划分区域,每个叶子的输出值则直接针对原损失函数重新优化。sklearn 的
GradientBoostingRegressor/Classifier和 5.9 节的伪代码采用的都是这种形式,5.5、5.6 节给出了各损失下 $\gamma_{jm}$ 的具体公式。
  graph TD
    A["选择损失函数 L"] --> B["计算伪残差
r = -∂L/∂F"]
    B --> C["训练回归树拟合 r"]
    C --> D["线搜索最优步长 ρ"]
    D --> E["更新模型 F ← F + ν·ρ·h"]
    E --> F{"是否收敛?"}
    F -->|否| B
    F -->|是| G["输出 F_M"]
5.5 回归版本(平方损失)的完整推导
对于回归问题,采用平方损失(Squared Error / Least Squares):
$$L(y, F) = \frac{1}{2}(y - F)^2$$符号说明:$y$ 为真实目标值;$F$ 为模型预测值;系数 $\frac{1}{2}$ 是为了求导时与平方项抵消,简化计算。
伪残差计算
$$r_{im} = -\frac{\partial}{\partial F}\left[\frac{1}{2}(y_i - F)^2\right]_{F=F_{m-1}} = -\left[-(y_i - F)\right]_{F=F_{m-1}} = y_i - F_{m-1}(x_i)$$关键结论:在平方损失下,伪残差恰好就是普通残差(观测值减去当前预测值)。因此,Gradient Boosting 回归的直观解释就是:
“每一棵新树拟合当前集成模型的残差,然后将该树的预测以学习率为权重加入集成。”
完整回归流程
Step 1:初始化
$$F_0(x) = \arg\min_\gamma \sum_{i=1}^{n} \frac{1}{2}(y_i - \gamma)^2 = \frac{1}{n}\sum_{i=1}^{n} y_i = \bar{y}$$符号说明:$\bar{y}$ 为训练集目标值的均值;$\gamma$ 为待优化的常数预测值。
在平方损失下,最优初始预测就是训练集的均值。这解释了为什么很多 Gradient Boosting 实现中 $F_0$ 被初始化为 mean(y)。
Step 2:迭代($m = 1, \dots, M$)
- 计算残差:$r_{im} = y_i - F_{m-1}(x_i)$
- 拟合回归树:$h_m(x)$ 对 $\{(x_i, r_{im})\}$ 拟合,生成叶子区域 $\{R_{jm}\}_{j=1}^{J_m}$
- 对每个叶子区域 $R_{jm}$,计算最优输出值:
符号说明:$R_{jm}$ 为第 $m$ 棵树的第 $j$ 个叶子区域;$\lvert R_{jm} \rvert$ 为该叶子中的样本数;$\gamma_{jm}$ 为叶子 $j$ 的最优输出值(即该叶子内残差的均值)。
- 更新模型:
符号说明:$\nu$ 为学习率(shrinkage);$\mathbb{I}(x \in R_{jm})$ 为指示函数(当 $x$ 落入叶子 $R_{jm}$ 时为 1,否则为 0)。
Step 3:输出 $F_M(x)$
  graph TD
    subgraph "GB 回归流程"
        A["初始化为目标均值"] --> B["计算当前残差"]
        B --> C["训练回归树拟合残差"]
        C --> D["对每个叶子计算最优值 γ_jm
叶子内残差均值"]
        D --> E["用叶子值累加更新模型"]
        E --> F{"M 轮完成?"}
        F -->|否| B
        F -->|是| G["输出 F_M"]
    end
其他回归损失:LAD、Huber 与分位数
平方损失对异常值敏感。Friedman (2001) 同时给出了几种稳健损失下的 TreeBoost 算法,它们的区别只在于三处:初始值 $F_0$、伪残差 $r_{im}$(见 5.4 节表格)以及叶子值 $\gamma_{jm}$。
| 损失 | 初始值 $F_0$ | 叶子值 $\gamma_{jm}$ |
|---|---|---|
| 平方损失(LS) | $\bar{y}$ | 叶子内残差 $y_i - F_{m-1}(x_i)$ 的均值 |
| 绝对损失(LAD) | $\operatorname{median}\{y_i\}$ | 叶子内残差 $y_i - F_{m-1}(x_i)$ 的中位数 |
| 分位数损失($\tau$) | $\{y_i\}$ 的 $\tau$ 分位数 | 叶子内残差的 $\tau$ 分位数 |
| Huber 损失(M-TreeBoost) | $\operatorname{median}\{y_i\}$ | 中位数加一步修正,见下式 |
LAD 与分位数损失的叶子值都是精确解:最小化 $\sum_{x_i \in R_{jm}} \lvert y_i - F_{m-1}(x_i) - \gamma \rvert$ 的 $\gamma$ 就是残差的中位数,分位数损失同理。注意此时树拟合的是伪残差 $\operatorname{sign}(y_i - F_{m-1}(x_i))$(只有 $\pm 1$),而叶子值却由原始残差决定,这正是 TreeBoost “树定划分、叶子单独优化"的体现。
Huber 损失没有闭式的叶子解。Friedman (2001) 每轮先把阈值 $\delta_m$ 取为当前残差绝对值 $\left\{\lvert y_i - F_{m-1}(x_i) \rvert\right\}$ 的 $\alpha$ 分位数,再用"中位数 + 一步修正"近似叶子值:记 $\tilde{r}_{jm}$ 为叶子 $R_{jm}$ 内残差 $r_{i} = y_i - F_{m-1}(x_i)$ 的中位数,$N_{jm}$ 为叶子样本数,
$$\gamma_{jm} = \tilde{r}_{jm} + \frac{1}{N_{jm}} \sum_{x_i \in R_{jm}} \operatorname{sign}\left(r_i - \tilde{r}_{jm}\right) \min\left(\delta_m, \lvert r_i - \tilde{r}_{jm} \rvert\right)$$sklearn 中 loss='huber' 和 loss='quantile' 共用参数 alpha:前者表示取残差绝对值的哪个分位数作为 $\delta_m$(默认 0.9),后者表示要估计的分位数 $\tau$。用 alpha=0.05 和 alpha=0.95 各训练一个分位数模型,即可得到 90% 预测区间。
5.6 分类版本(对数损失)的推导
对于二分类问题,Gradient Boosting 使用对数损失(Log Loss / Binomial Deviance):
$$L(y, F) = -y \log\big(\sigma(F)\big) - (1-y) \log\big(1 - \sigma(F)\big)$$符号说明:$y \in \{0, 1\}$ 为类别标签;$\sigma(F) = \frac{1}{1 + e^{-F}}$ 为 logistic sigmoid 函数;$F(x)$ 输出的不是概率,而是log-odds(对数几率)。
伪残差计算
$$r_{im} = -\frac{\partial L}{\partial F}\bigg|_{F_{m-1}} = y_i - \sigma\big(F_{m-1}(x_i)\big) = y_i - p_i$$符号说明:$p_i = \sigma(F_{m-1}(x_i))$ 是当前模型对样本 $i$ 预测为正类的概率。
关键观察:
- 即使对于分类任务,每棵新树仍然是回归树,因为它拟合的是连续梯度值(概率与标签之差),而非离散类别。
- 模型输出 $F(x)$ 是 log-odds,最终概率通过 $\sigma(F)$ 转换得到。
- 当 $y_i = 1$ 时,若 $p_i$ 接近 0(模型预测错误),则伪残差接近 1(模型应大幅增加该样本的 log-odds);若 $p_i$ 接近 1(模型预测正确),则伪残差接近 0(模型已正确预测,无需大幅调整)。
- 伪残差的取值范围是 $(-1, 1)$,即使样本被严重错分,它对新树的"拉力"也是有界的,这是对数损失比指数损失更稳健的原因之一。
初始值与叶子值(Newton 步)
初始值:最优常数满足 $\sum_i \left(y_i - \sigma(\gamma)\right) = 0$,即 $\sigma(\gamma) = \bar{y}$:
$$F_0(x) = \log\frac{\bar{y}}{1 - \bar{y}}$$即训练集正类比例 $\bar{y}$ 的对数几率(sklearn 的默认初始化正是如此)。
叶子值:对数损失下 $\gamma_{jm} = \arg\min_{\gamma} \sum_{x_i \in R_{jm}} L\left(y_i, F_{m-1}(x_i) + \gamma\right)$ 没有闭式解。记 $g_i$、$h_i$ 为损失对 $F$ 的一阶、二阶导数:
$$g_i = \frac{\partial L}{\partial F} = p_i - y_i, \qquad h_i = \frac{\partial^2 L}{\partial F^2} = p_i(1 - p_i)$$从 $\gamma = 0$ 出发做一步 Newton-Raphson 近似:
$$\gamma_{jm} \approx -\frac{\sum_{x_i \in R_{jm}} g_i}{\sum_{x_i \in R_{jm}} h_i} = \frac{\sum_{x_i \in R_{jm}} (y_i - p_i)}{\sum_{x_i \in R_{jm}} p_i (1 - p_i)}$$这就是 sklearn GradientBoostingClassifier 计算叶子值的方式(源码注释引用的正是 FHT 2000 的 Newton 步)。Friedman (2001) 原文使用 $y \in \{-1, +1\}$ 与 $L = \log\left(1 + e^{-2yF}\right)$ 的参数化,伪残差为 $\tilde{y}_i = \frac{2y_i}{1 + e^{2y_i F_{m-1}(x_i)}}$,相应的叶子值为 $\gamma_{jm} = \frac{\sum \tilde{y}_i}{\sum \lvert \tilde{y}_i \rvert \left(2 - \lvert \tilde{y}_i \rvert\right)}$,与上式只差参数化方式。
这里只用了一步 Newton,而不是在每个叶子里把 $\gamma$ 优化到收敛,是计算量和精度之间的折中。XGBoost 把"二阶信息"进一步用到了树的分裂准则上(第 6 章)。
多分类情况(K 类)
对于 K 类多分类问题,需要为每个类别 $k = 1, \dots, K$ 维护一个独立的函数 $F_k(x)$。使用多项式偏差损失(Multinomial Deviance):
$$L\big(y, \{F_k\}\big) = -\sum_{k=1}^{K} \mathbb{I}(y = G_k) \log\big(p_k(x)\big)$$符号说明:$G_k$ 为第 $k$ 个类别;$\mathbb{I}(y = G_k)$ 为指示函数(当样本真实类别为 $G_k$ 时为 1,否则为 0)。
类别概率通过 softmax 计算:
$$p_k(x) = \frac{\exp\big(F_k(x)\big)}{\sum_{l=1}^{K} \exp\big(F_l(x)\big)}$$符号说明:$p_k(x)$ 为样本 $x$ 属于类别 $k$ 的概率;$F_k(x)$ 为类别 $k$ 的得分函数(logit)。由于 softmax 对所有 $F_k$ 同加一个函数不变,$F_k$ 只确定到相差一个公共项,Friedman (2001) 用约束 $\sum_{k=1}^K F_k(x) = 0$ 消除这一自由度。
伪残差(对于类别 $k$):
$$r_{ikm} = y_{ik} - p_{k, m-1}(x_i)$$符号说明:$y_{ik} = \mathbb{I}(y_i = G_k)$ 为类别 $k$ 的指示标签;$p_{k, m-1}(x_i)$ 为当前模型对类别 $k$ 的概率预测。
多分类算法流程
- 初始化:$F_{k0}(x) = 0$(Friedman 2001 原文);sklearn 默认用各类先验概率的对数 $\log \bar{y}_k$(再减去各类的平均值,使 $\sum_k F_{k0} = 0$)初始化,其中 $\bar{y}_k$ 为第 $k$ 类样本的比例
- 对于 $m = 1, \dots, M$:
- 用当前得分计算概率 $p_{k, m-1}(x_i)$(softmax)
- 对每个类别 $k = 1, \dots, K$:
- 计算伪残差:$r_{ikm} = y_{ik} - p_{k, m-1}(x_i)$
- 拟合回归树 $h_{km}(x)$ 到伪残差
- 计算每个叶子区域的最优值(用一步 Newton-Raphson 近似,Friedman 2001 算法 6):
符号说明:$R_{jkm}$ 为第 $m$ 轮类别 $k$ 的第 $j$ 个叶子区域;$\gamma_{jkm}$ 为该叶子的最优输出值。因子 $\frac{K-1}{K}$ 来自 $\sum_k F_k = 0$ 的约束。
- 更新:$F_{km}(x) = F_{k, m-1}(x) + \nu \sum_{j} \gamma_{jkm} \, \mathbb{I}(x \in R_{jkm})$
- 输出:$\hat{y} = \arg\max_k F_{kM}(x)$,类别概率为 $p_k(x) = \operatorname{softmax}\left(F_{1M}(x), \ldots, F_{KM}(x)\right)_k$
注意:每轮迭代需要拟合 $K$ 棵树,因此多分类 Gradient Boosting 的训练时间是二分类的约 $K$ 倍。
  graph TD
    subgraph "GB 二分类流程"
        A["初始化 F_0 = log(ȳ/(1-ȳ))
(正类比例的对数几率)"] --> B["计算伪残差 r_i = y_i - p_i"]
        B --> C["训练回归树拟合 r_i"]
        C --> D["更新 log-odds"]
        D --> E["计算新概率 p = σ(F_m)"]
        E --> F{"M 轮完成?"}
        F -->|否| B
        F -->|是| G["输出 sign(F_M)"]
    end
5.7 正则化技术:Shrinkage、子采样、列采样、树复杂度控制
Gradient Boosting 是贪婪算法,容易过拟合。Friedman 在 2001 和 2002 年的论文中提出了多种正则化策略,这些策略是现代 Gradient Boosting 实现(如 XGBoost、LightGBM)的基础。
Shrinkage(学习率收缩)
核心公式:
$$F_m(x) = F_{m-1}(x) + \nu \sum_{j=1}^{J_m} \gamma_{jm} \, \mathbb{I}(x \in R_{jm}), \quad 0 < \nu \leq 1$$符号说明:$\nu$ 为学习率(shrinkage factor),常用取值在 $0.01$ 到 $0.3$ 之间;$\gamma_{jm}$ 为第 $m$ 棵树各叶子的最优值(5.4 节)。
作用机制:
- 当 $\nu = 1$ 时,每棵树按(叶子内)最优步长完整地修正当前误差,训练损失下降很快,模型也更容易过拟合训练数据。
- 当 $\nu < 1$ 时,每棵树只贡献部分修正,将学习过程分散到更多轮迭代中。
- 小的 $\nu$ 使得模型对学习更"谨慎”,大量弱学习器的平均效应能抵消单个树的噪声,显著提高泛化能力。
经验规律:学习率与树数量之间存在权衡关系:
| learning_rate | n_estimators 建议 | 适用场景 |
|---|---|---|
| 0.1 | 100~500 | 默认配置,平衡速度和质量 |
| 0.05 | 500~2000 | 更高精度,容忍更慢训练 |
| 0.01 | 2000+ | 追求极致性能,配合早停 |
Friedman (2001) 通过实验发现,使用较小的学习率(如 $\nu = 0.1$ 或更小)配合足够多的树,能显著提升模型的泛化性能。ESL 第 10.12.1 节总结为:在相同轮数下,$\nu$ 越小训练误差越大,但经验上 $\nu < 0.1$ 通常能得到更好的测试误差,代价是需要相应更大的 $M$。因此实践中的策略通常是:先把 $\nu$ 设得较小,再用验证集或早停来确定 $M$。
为什么收缩有效:在平方损失、小步长的极限下,“收缩 + 前向分步"会逼近一种类似 $L_1$ 正则化(Lasso)的路径(ESL 第 16.2 节讨论了 $\varepsilon$-forward stagewise 与 Lasso 的联系),这为收缩提供了一种正则化解释。
子采样(Stochastic Gradient Boosting)
Friedman (2002) 在论文 “Stochastic Gradient Boosting” 中提出,受 Breiman 的 Bagging 启发,在每次迭代中无放回随机抽取训练集的一个子集来拟合当前树。
算法修改:
- 在每轮迭代 $m$ 中,从训练集中抽取比例 $f$(通常 $f = 0.5$)的样本子集 $S_m$
- 仅使用 $S_m$ 计算伪残差并拟合 $h_m$
- 更新时仍应用于全部训练样本的预测
ESL 第 10.12.2 节指出,典型的抽样比例为 $1/2$,样本量 $N$ 很大时还可以显著小于 $1/2$。在 sklearn 中设置 subsample < 1.0 即启用随机梯度提升,此时每轮未被抽中的样本可作为袋外(OOB)样本,oob_improvement_ 记录了每一轮在 OOB 样本上的损失改进,可用来粗略估计合适的迭代轮数。
正则化效果:
- 降低方差:不同树使用不同数据子集,增加了树之间的多样性,类似于 Bagging 的方差削减机制(sklearn 文档:
subsample < 1.0会降低方差、增大偏差)。 - 防止过拟合:随机性阻止模型对训练集的个别样本或异常值过度记忆。
- 加速训练:每棵树只需拟合更小数据集。
列采样(Column Subsampling)
借鉴随机森林的思想,在每次分裂(或每棵树)时只考虑特征的一个随机子集:
- 按分裂采样:sklearn 的
max_features表示每次寻找最佳分裂时考虑的特征数(XGBoost 中对应colsample_bynode)。 - 按树 / 按层采样:XGBoost 的
colsample_bytree(每棵树采样一次)和colsample_bylevel(树的每一层采样一次),LightGBM 的feature_fraction(按树)。
效果:降低树之间的相关性,减少方差,尤其适用于高维特征空间。
树复杂度控制
| 技术 | 参数 | 典型范围 | 作用 |
|---|---|---|---|
| 树深度限制 | max_depth | 3~6 | 限制每棵树的交互复杂度,depth=d 最多捕捉 d-way 特征交互 |
| 叶子最小样本 | min_samples_leaf | 5~50 | 防止叶子节点对单个样本过拟合,平滑预测 |
| 分裂最小样本 | min_samples_split | 2~20 | 控制节点分裂条件,避免过细分裂 |
| 最大叶子节点 | max_leaf_nodes | - | 直接控制树的大小,替代 max_depth |
| 纯度减少阈值 | min_impurity_decrease | 0 | 预剪枝控制,分裂必须带来足够收益 |
经验:深度 3 的树可捕捉最多 3-way 特征交互;深度过大会快速记忆噪声。更一般地,有 $J$ 个叶子的树最多能表示 $J-1$ 阶的特征交互。ESL 第 10.11 节的经验是:叶子数 $4 \leq J \leq 8$ 在 Boosting 中通常效果良好,且在这个范围内结果对具体取值不太敏感;$J = 2$(树桩)只能得到不含交互项的加性模型。
正则化技术总结表
| 正则化技术 | 参数名 | 作用机制 | 来源 | 建议 |
|---|---|---|---|---|
| Shrinkage | learning_rate ($\nu$) | 缩放每棵树贡献 | Friedman (2001) | 0.01~0.1,配合更多树 |
| 行子采样 | subsample | 每棵树随机子集训练 | Friedman (2002) | 0.5~0.8,降低方差 |
| 列子采样 | max_features | 每次分裂随机选取部分特征 | 随机森林思想 | sqrt 或 log2 |
| 树深度限制 | max_depth | 限制模型复杂度 | 通用 | 3~5 为典型值 |
| 叶子最小样本 | min_samples_leaf | 平滑叶子预测 | 通用 | 5~50 |
| 早停 | n_iter_no_change | 验证集损失不提升则停止 | 通用 | 设置 10~20 轮早停 |
  graph TD
    A["Gradient Boosting
容易过拟合"] --> B["Shrinkage
learning_rate"]
    A --> C["子采样
subsample"]
    A --> D["列采样
max_features"]
    A --> E["树复杂度控制
max_depth/min_samples_leaf"]
    A --> F["早停
n_iter_no_change"]
    B --> G["降低每棵树影响
分散学习过程"]
    C --> H["增加树间多样性
Bagging式方差削减"]
    D --> I["减少特征相关性
防止主导特征过拟合"]
    E --> J["限制单树复杂度
防止记忆噪声"]
    F --> K["防止无效迭代
节省计算资源"]
    G --> L["最终效果:
提升泛化性能"]
    H --> L
    I --> L
    J --> L
    K --> L
5.8 sklearn API 与关键参数详解
scikit-learn 提供了 GradientBoostingClassifier 和 GradientBoostingRegressor 两个类,实现了经典的 Gradient Boosting Machine。
GradientBoostingRegressor
| |
GradientBoostingClassifier
| |
注意:即使做分类,
GradientBoostingClassifier内部拟合的仍是回归树(预测梯度值),最终通过 sigmoid 或 softmax 得到概率。二分类每轮只拟合 1 棵树,$K$ 分类每轮拟合 $K$ 棵树。版本提示:样本量较大(sklearn 文档建议
n_samples >= 10_000)时,sklearn 推荐使用基于直方图的HistGradientBoostingRegressor/Classifier,速度快得多(见第 9、10 章)。
关键参数说明表
| 参数 | 作用 | 建议 |
|---|---|---|
loss | 损失函数类型 | 噪声多用 'huber',需预测区间用 'quantile' |
learning_rate | 每棵树贡献缩放因子 | 0.01~0.1,越小需越多树 |
n_estimators | 总树数 | 与 learning_rate 配合调整 |
subsample | 每棵树使用样本比例 | 0.5~0.8 可降低方差 |
max_depth | 树深度 | 3~5 为典型值,回归常用 3 |
max_features | 每次分裂的特征采样 | 'sqrt' 或 'log2' 可减少过拟合 |
min_samples_leaf | 叶子最小样本 | 5~50 可防止过拟合 |
n_iter_no_change | 早停轮数 | 设置 10 后自动启用早停 |
参数调优建议
- 固定
learning_rate = 0.1,先用GridSearchCV或RandomizedSearchCV搜索n_estimators和max_depth。 - 降低
learning_rate(如 0.05 或 0.01),同时增加n_estimators(500+),使用早停 (n_iter_no_change)。 - 启用子采样:设置
subsample=0.8或0.5,通常与 shrinkage 有协同效果。 - 特征采样:高维数据可设置
max_features='sqrt'。
5.9 伪代码
算法: Gradient Tree Boosting(回归版本)
- 输入:训练集 $\{(x_i, y_i)\}_{i=1}^n$,损失函数 $L(y, F)$,迭代次数 $M$,学习率 $\nu$,树深度 $d$
- 输出:最终模型 $F_M(x)$
- 初始化: $$F_0(x) \leftarrow \arg\min_\gamma \sum_i L(y_i, \gamma)$$ (对平方损失,$F_0(x) = \bar{y}$)
- For $m = 1, 2, \ldots, M$ do:
- 计算伪残差: $$r_i \leftarrow -\left[\frac{\partial L(y_i, F(x_i))}{\partial F(x_i)}\right]_{F=F_{m-1}}, \quad i = 1,\ldots,n$$
- 拟合回归树: $$h_m(x) \leftarrow \operatorname{TreeFit}\left(\{(x_i, r_i)\}_{i=1}^n;\ d\right)$$ 即用最大深度为 $d$ 的回归树以平方误差拟合 $\{(x_i, r_i)\}$,产生叶子区域 $\{R_{jm}\}_{j=1}^{J_m}$
- For 每个叶子 $j = 1, \ldots, J_m$ do: $$\gamma_{jm} \leftarrow \arg\min_\gamma \sum_{x_i \in R_{jm}} L(y_i, F_{m-1}(x_i) + \gamma)$$ (对平方损失:$\gamma_{jm} = \frac{1}{\lvert R_{jm} \rvert}\sum_{x_i \in R_{jm}} r_i$,即叶子内残差均值;其他损失见 5.5、5.6 节)
- 更新模型: $$F_m(x) \leftarrow F_{m-1}(x) + \nu \sum_{j=1}^{J_m} \gamma_{jm} \, \mathbb{I}(x \in R_{jm})$$
- 返回 $F_M(x)$
5.10 Python 从零实现(回归 + 分类,逐行注释)
| |
5.11 与 sklearn 的对比验证
以下代码展示了如何将自定义实现与 sklearn 的 GradientBoostingRegressor 和 GradientBoostingClassifier 进行系统性的对比验证。
| |
5.12 模型解释:相对重要性与部分依赖图
Friedman (2001) 在提出 GBM 的同时,还给出了两种解释树集成模型的工具(ESL 第 10.13 节),至今仍被广泛使用。
相对重要性(Relative Importance):对单棵有 $J$ 个叶子($J-1$ 个内部节点)的树 $T$,特征 $X_\ell$ 的重要性定义为
$$\mathcal{I}_\ell^2(T) = \sum_{t=1}^{J-1} \hat{\imath}_t^2 \, \mathbb{I}\left(v(t) = \ell\right)$$其中 $v(t)$ 为内部节点 $t$ 使用的分裂特征,$\hat{\imath}_t^2$ 为该次分裂带来的平方误差下降量。对 $M$ 棵树取平均即得到集成的重要性 $\mathcal{I}_\ell^2 = \frac{1}{M}\sum_{m=1}^{M} \mathcal{I}_\ell^2(T_m)$。sklearn 的 feature_importances_ 就是这类基于不纯度下降的重要性(并归一化为和为 1)。需要注意,sklearn 文档提醒这种重要性偏向取值多(高基数)的特征,并且是在训练集上计算的;必要时可以改用 sklearn.inspection.permutation_importance 在验证集上计算置换重要性。
部分依赖(Partial Dependence):把特征分为关心的子集 $X_S$ 和其余特征 $X_C$,定义
$$\bar{f}_S(x_S) = \frac{1}{n} \sum_{i=1}^{n} F\left(x_S, x_{iC}\right)$$即把每个训练样本的 $X_S$ 都替换成 $x_S$、其余特征保持不变,再对模型预测取平均。它刻画了在平均掉其他特征之后,模型输出如何随 $x_S$ 变化。sklearn 中可用 sklearn.inspection.PartialDependenceDisplay.from_estimator 绘制。当 $X_S$ 与 $X_C$ 强相关时,这种"替换"会产生现实中不存在的特征组合,解读时需要谨慎。
参考文献
第4章(AdaBoost)核心文献
- Freund, Y. & Schapire, R. E. (1997). “A Decision-Theoretic Generalization of On-Line Learning and an Application to Boosting.” Journal of Computer and System Sciences, 55(1), 119-139.
- Freund, Y. & Schapire, R. E. (1996). “Experiments with a New Boosting Algorithm.” ICML.
- Friedman, J., Hastie, T. & Tibshirani, R. (2000). “Additive Logistic Regression: A Statistical View of Boosting.” The Annals of Statistics, 28(2), 337-407.
- Schapire, R. E., Freund, Y., Bartlett, P. & Lee, W. S. (1998). “Boosting the Margin: A New Explanation for the Effectiveness of Voting Methods.” The Annals of Statistics, 26(5), 1651-1686.
- Zhu, J., Zou, H., Rosset, S. & Hastie, T. (2009). “Multi-class AdaBoost.” Statistics and Its Interface, 2(3), 349-360.(2006 年技术报告版本)
- Drucker, H. (1997). “Improving Regressors using Boosting Techniques.” ICML, 107-114.
- Wyner, A. J. (2003). “On Boosting and the Exponential Loss.” Proceedings of the Ninth International Workshop on Artificial Intelligence and Statistics (AISTATS 2003), 323-329.
- Schapire, R. E. & Singer, Y. (1999). “Improved Boosting Algorithms Using Confidence-rated Predictions.” Machine Learning, 37(3), 297-336.
- Breiman, L. (1999). “Prediction Games and Arcing Algorithms.” Neural Computation, 11(7), 1493-1517.
- Reyzin, L. & Schapire, R. E. (2006). “How Boosting the Margin Can Also Boost Classifier Complexity.” Proceedings of ICML 2006.
- Long, P. M. & Servedio, R. A. (2010). “Random Classification Noise Defeats All Convex Potential Boosters.” Machine Learning, 78(3), 287-304.
- Freund, Y. (2009). “A More Robust Boosting Algorithm.” arXiv:0905.2138.
- Schapire, R. E. (2013). “Explaining AdaBoost.” In Empirical Inference, Springer, 37-52.
- 李航. (2019). 《统计学习方法》(第 2 版). 清华大学出版社. 第 8 章.
第5章(Gradient Boosting)核心文献
- Friedman, J. H. (2001). “Greedy Function Approximation: A Gradient Boosting Machine.” The Annals of Statistics, 29(5), 1189-1232.
- Friedman, J. H. (2002). “Stochastic Gradient Boosting.” Computational Statistics & Data Analysis, 38(4), 367-378.
- Hastie, T., Tibshirani, R. & Friedman, J. (2009). The Elements of Statistical Learning (2nd ed.). Springer. Chapter 10.
- Bühlmann, P. & Hothorn, T. (2007). “Boosting Algorithms: Regularization, Prediction and Model Fitting.” Statistical Science, 22(4), 477-505.
- scikit-learn 官方文档:
GradientBoostingRegressor、GradientBoostingClassifier、AdaBoostClassifier、AdaBoostRegressorAPI 参考(1.9 版)。
生成日期:2026-06-30。 编写角色:经典算法撰写员。