
Boosting 家族算法众多,从经典的 AdaBoost 到现代的 XGBoost、LightGBM、CatBoost,每种算法都有其独特的设计哲学、优化方向和适用场景。在实际项目中,选择正确的算法往往比精细调参更能决定最终效果。本文从多维度对五大主流 Boosting 算法进行系统对比,并给出可操作的算法选择决策流程。
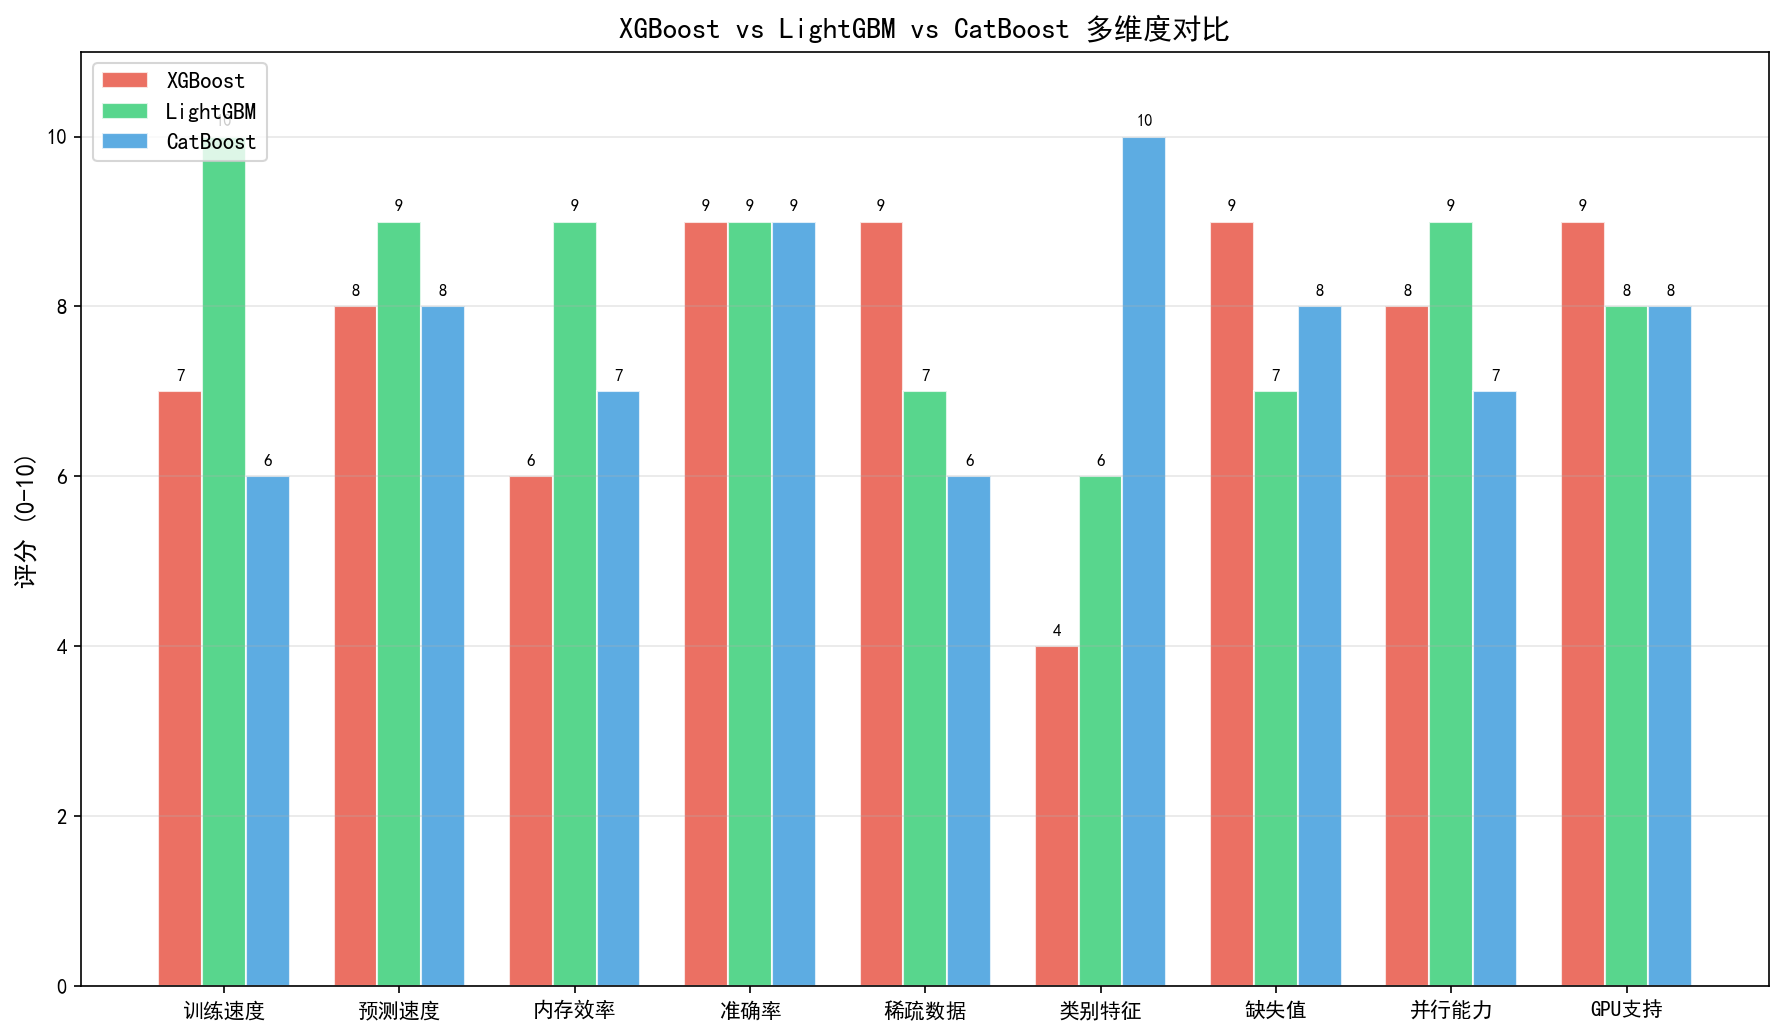
下面从训练与预测速度、内存占用、准确率和特征处理几个方面比较这些算法。
9.1 五大 Boosting 算法横向对比
下表从训练速度、预测速度、内存占用、准确率、默认参数行为、稀疏数据支持、缺失值处理、类别特征处理、GPU 支持、并行能力和典型适用场景等 11 个维度,对 AdaBoost、Gradient Boosting Machine (GBM)、XGBoost、LightGBM 和 CatBoost 进行横向对比。
| 对比维度 | AdaBoost (sklearn) | GBM (sklearn) | XGBoost | LightGBM | CatBoost |
|---|---|---|---|---|---|
| 核心思想 | 样本重加权 + 指数损失 | 函数空间梯度下降(一阶) | 二阶泰勒展开 + 显式正则化 | 直方图 + Leaf-wise + GOSS/EFB | Ordered Boosting + Oblivious Trees |
| 训练速度 | ⭐⭐⭐ 较慢(串行,单线程,每轮需完整训练弱学习器) | ⭐⭐⭐ 较慢(Cython 实现,单线程,精确贪心分裂,无直方图) | ⭐⭐⭐⭐ 快(C++ 核心,多线程,2.0 起默认 hist 直方图算法) | ⭐⭐⭐⭐⭐ 通常最快(直方图 + Leaf-wise 生长 + EFB;可选 GOSS 采样) | ⭐⭐⭐⭐ 快(对称树;类别特征的有序目标统计有额外开销,显式开启 Ordered 模式时更慢) |
| 预测速度 | ⭐⭐⭐⭐⭐ 极快(决策树桩,预测仅需少量判断) | ⭐⭐⭐⭐ 快(树深较浅) | ⭐⭐⭐⭐ 快(树结构紧凑) | ⭐⭐⭐⭐ 快(树可能更深但节点少) | ⭐⭐⭐⭐⭐ 很快(对称树,每层只需一次比较,便于向量化) |
| 内存占用 | ⭐⭐⭐⭐⭐ 极低(模型仅为若干树桩) | ⭐⭐⭐⭐ 较低(直接在原始浮点数据上训练) | ⭐⭐⭐⭐ 较低(hist 下存储压缩后的分桶索引;QuantileDMatrix 可进一步省内存) | ⭐⭐⭐⭐⭐ 极低(分桶后用 uint8 等紧凑整数存储) | ⭐⭐⭐⭐ 较低(数值特征量化为分桶后存储) |
| 默认准确率 | ⭐⭐⭐ 中等(基线水平) | ⭐⭐⭐⭐ 良好(经典实现) | ⭐⭐⭐⭐⭐ 优秀(正则化 + 二阶优化) | ⭐⭐⭐⭐⭐ 优秀(Leaf-wise 更精细拟合) | ⭐⭐⭐⭐⭐ 优秀(默认参数稳健,有序目标统计减少类别特征的目标泄漏) |
| 默认参数 | 较友好(默认 n_estimators=50、learning_rate=1.0,主要调这两项和基学习器深度) | 较友好(max_depth=3、learning_rate=0.1,较保守) | 较激进(max_depth=6,eta=0.3,需调参) | 较激进(num_leaves=31、max_depth=-1 不限深度,需配合 min_data_in_leaf 等) | 极友好(几乎无需调参,开箱即用) |
| 稀疏数据支持 | ⭐⭐⭐ 一般(接受 scipy 稀疏矩阵,但无专门优化) | ⭐⭐⭐ 一般(接受 scipy 稀疏矩阵,但无专门优化) | ⭐⭐⭐⭐⭐ 优秀(稀疏感知分裂,自动处理缺失/零值) | ⭐⭐⭐⭐⭐ 优秀(直方图构建跳过零值/最频繁分桶,EFB 捆绑互斥稀疏特征) | ⭐⭐⭐⭐ 良好(支持稀疏输入) |
| 缺失值处理 | 需预处理(含 NaN 时 fit 报错) | 需预处理(含 NaN 时 fit 报错) | ⭐⭐⭐⭐⭐ 自动学习缺失值的默认方向 | ⭐⭐⭐⭐⭐ 自动学习缺失值的默认方向(use_missing=true) | ⭐⭐⭐⭐⭐ 数值特征默认把缺失视为最小值(nan_mode='Min') |
| 类别特征处理 | 需 One-Hot 等编码 | 需 One-Hot 等编码 | ⭐⭐⭐⭐ 1.5 起原生支持(enable_categorical=True,pandas category 列) | ⭐⭐⭐⭐ 原生支持(非负整数或 pandas category,按梯度统计排序后划分) | ⭐⭐⭐⭐⭐ 原生支持(有序目标统计 Ordered TS + 特征组合) |
| GPU 支持 | ❌ 无 | ❌ 无 | ✅ 有(2.0 起用 device='cuda',旧写法 gpu_hist 已弃用) | ✅ 有(device_type='gpu' 为 OpenCL 版,'cuda' 为 CUDA 版,需相应构建) | ✅ 有(task_type='GPU',支持多卡) |
| 并行能力 | ⭐⭐ 弱(无 n_jobs 参数,弱学习器串行训练) | ⭐⭐ 弱(无 n_jobs 参数,单线程) | ⭐⭐⭐⭐ 强(OpenMP 多线程,支持 Dask、Spark 等分布式训练) | ⭐⭐⭐⭐⭐ 极强(特征并行、数据并行、投票并行) | ⭐⭐⭐⭐ 强(CPU 多线程 thread_count,多 GPU) |
| 典型适用场景 | 快速基线、小数据二分类、教学演示 | 中小规模数据、需要 sklearn 生态集成 | 竞赛首选、大规模表格数据、需要自定义目标函数 | 超大规模数据、高维特征、内存受限环境 | 含大量类别特征的数据、需要即插即用、小数据集上追求稳健的默认效果 |
关于 sklearn 的
HistGradientBoosting:上表中的 “GBM (sklearn)” 指经典的GradientBoostingClassifier/GradientBoostingRegressor。scikit-learn 另有受 LightGBM 启发的HistGradientBoostingClassifier/HistGradientBoostingRegressor(0.21 版以实验特性引入,1.0 版起转为稳定):它使用直方图算法和 OpenMP 多线程,原生支持缺失值(自动学习缺失值去向)和类别特征(1.6 起默认categorical_features='from_dtype',自动识别 pandas/polars 的 category 列),并支持单调约束、交互约束和内置早停。官方文档建议样本数达到数万以上时优先用它代替经典 GBM。
深入解读关键差异
1. 训练速度的差异来源
AdaBoost 和 sklearn 的经典 GBM 以 sklearn 决策树为基学习器,采用精确贪心分裂:在每个节点对每个特征的取值排序,再逐一扫描候选分裂点,单个节点的复杂度可近似理解为 $O(nd\log n)$,其中 $n$ 为样本数,$d$ 为特征数。XGBoost 与 LightGBM 的直方图方法把连续特征离散为 $b$ 个桶:构建直方图约为 $O(nd)$,在桶上搜索分裂约为 $O(db)$。由于 $b$ 通常远小于 $n$,排序和候选点扫描成本明显降低。LightGBM 进一步采用 Leaf-wise 树生长策略和 EFB(互斥特征捆绑),并可选用 GOSS(基于梯度的单边采样;默认不启用,4.x 中通过 data_sample_strategy='goss' 开启),在大规模数据上通常更快。CatBoost 在 CPU 上默认使用 boosting_type='Plain'(经典梯度提升方案,仍内置类别特征的有序目标统计);只有显式设置 boosting_type='Ordered',或在 GPU 上样本数不超过 5 万且非多分类时,才默认采用 Ordered Boosting。类别特征的目标统计和特征组合会带来额外开销,Ordered 模式更慢,因此 CatBoost 在纯速度上通常略逊于 LightGBM,但显著优于经典 GBM。
2. 内存占用的差异来源
LightGBM 的直方图方法默认把连续特征离散化为最多 255 个桶(max_bin=255),每个取值只需存一个 uint8 分桶索引,相比 float64 原始数据约为 $1/8$。XGBoost 在默认的 hist 树方法下同样只存储压缩后的分桶索引(默认 max_bin=256),用 QuantileDMatrix 还可以跳过保存原始数据的中间副本;早期 exact 方法使用的预排序 Block 结构才需要保存原始浮点值。CatBoost 也会先把数值特征量化为分桶(CPU 默认 border_count=254)。AdaBoost 的决策树桩仅存储一个分裂阈值和一个特征索引,模型本身的内存占用几乎可以忽略,但训练时仍需在原始浮点数据上排序。
3. 默认准确率与参数敏感性
CatBoost 以"开箱即用"著称,默认参数在许多数据集上已有较强表现,学习率还会根据数据规模和迭代数自动确定(见第 10 章)。XGBoost 和 LightGBM 的默认参数较为激进(如 XGBoost 默认 max_depth=6、eta=0.3),在中小数据集上容易过拟合,必须经过调参。AdaBoost 的默认决策树桩(max_depth=1)通常欠拟合,需要增加树深度或迭代次数才能释放潜力。sklearn GBM 的默认 max_depth=3 相对保守,是一个不错的起点。
4. 缺失值与稀疏数据
XGBoost 的稀疏感知分裂(Sparsity-aware Split Finding)是其标志性创新:在每次分裂时,算法自动学习缺失值应该走左子树还是右子树,通过枚举两种方向并选择增益更大的方案。这一机制不仅处理缺失值,还统一处理 one-hot 编码产生的零值和统计稀疏性。LightGBM 在构建直方图时跳过零值(以及最频繁的分桶),缺失值处理方式与 XGBoost 类似:默认 use_missing=true,分裂时分别尝试把缺失值放到左、右两侧并保留增益更大的方向;设置 zero_as_missing=true 时会把零也当作缺失。CatBoost 对数值特征默认使用 nan_mode='Min',把缺失值视为小于所有取值,并保证候选分裂中包含"缺失值 vs. 其他值"这一划分;对类别特征则不做特殊处理,缺失值就是一个普通的类别取值。相比之下,经典的 AdaBoost 和 sklearn GBM 需要用户在预处理阶段填充缺失值(如均值、中位数或特殊值填充),否则训练会报错(sklearn 的 HistGradientBoosting 和 1.4 起的随机森林则支持 NaN)。
5. 类别特征的原生支持
三个现代库都能原生处理类别特征,但做法不同。CatBoost 把类别特征转换为数值的有序目标统计量(Ordered Target Statistics,Ordered TS):每个样本只使用随机排列中排在它之前的样本的标签计算统计量,从而避免传统目标编码(Target Encoding)中的目标泄漏;它还会自动构造类别特征组合。LightGBM 要求类别特征为非负整数或 pandas category(pandas category 列可自动识别,numpy 输入需通过 categorical_feature 声明),分裂时按各类别的梯度统计量排序后寻找最优划分。XGBoost 自 1.5 起在 hist/approx 树方法下支持类别特征(enable_categorical=True 配合 pandas category 列),1.6 起支持最优划分(partition-based split)。经典的 AdaBoost 和 sklearn GBM 则要求用户在训练前对类别特征编码(One-Hot 编码或序数编码),One-Hot 编码在高基数特征上会产生大量稀疏列,影响树模型的分裂效率。
9.2 算法选择决策树
面对具体项目,如何快速选择最合适的 Boosting 算法?以下 Mermaid 流程图提供了一个系统化的决策路径。
  flowchart TD
    A["开始: 分析数据集特征"] --> B{"数据规模?"}
    B -->|小样本低维| C{"是否有大量类别特征?"}
    B -->|大样本或高维| D{"对训练速度敏感?"}

    C -->|是| E["CatBoost 优先
原生类别特征支持
开箱即用"]
    C -->|否| F{"需要快速基线?"}
    F -->|是| G["AdaBoost
决策树桩快速训练
适合理解原理"]
    F -->|否| H["sklearn HistGradientBoosting / GBM
无额外依赖
与 sklearn 生态无缝集成"]

    D -->|是| I{"内存是否受限?"}
    D -->|否| J{"是否有大量类别特征?"}

    I -->|是| K["LightGBM
直方图低内存
Leaf-wise 快速训练"]
    I -->|否| L["XGBoost 或 LightGBM
两者速度均优秀"]

    J -->|是| E
    J -->|否| M{"是否需要 GPU 加速?"}
    M -->|是| N["XGBoost 或 CatBoost
GPU 支持成熟
LightGBM 需 GPU 构建"]
    M -->|否| O{"是否需要解释性/自定义目标?"}
    O -->|是| P["XGBoost
自定义目标函数
SHAP 支持完善"]
    O -->|否| Q{"追求极致速度 or 极致准确率?"}
    Q -->|速度| K
    Q -->|准确率| R["XGBoost 或 CatBoost
竞赛级准确率"]
关键决策节点解读
节点 B:数据规模判断
数据规模是算法选择的首要考量。对于小数据集(样本数 $< 10,000$,特征数 $< 50$),算法本身的训练时间差异不大,此时应优先考虑准确率和易用性。CatBoost 在小数据上默认效果通常较稳健,且无需复杂的类别特征预处理;样本较少时还可以显式尝试 boosting_type='Ordered'。对于大数据集,训练速度和内存占用成为瓶颈,必须选择现代高效实现(XGBoost、LightGBM、CatBoost)。
节点 D:训练速度敏感度
如果项目需要频繁重新训练模型(如每日更新的推荐系统、实时风控模型),训练速度至关重要。LightGBM 通常是训练速度最快的选择,特别是在高维数据上。如果训练是一次性的(如年度客户流失预测),速度可以适度妥协以换取更高的准确率。
节点 I:内存受限环境
在边缘设备、嵌入式系统或大规模分布式集群的单个 worker 上,内存可能受限。LightGBM 的直方图方法通常把特征值压缩为 8 位整数分桶索引,内存占用很低(XGBoost 的 hist 方法也采用类似的压缩存储)。如果内存极其紧张(如仅几百 MB 可用),甚至可以考虑 AdaBoost(决策树桩几乎不占内存),但需接受较低的准确率。
节点 J:类别特征数量
如果数据集中包含大量类别特征(如用户 ID、商品类目、地理位置编码),CatBoost 是首选。其 Ordered TS 编码免去了手工预处理,在高基数(high cardinality)特征上通常也比 One-Hot 编码更合适。例如,在含有 1000 个类别的特征上,One-Hot 编码会产生 1000 个二元列,导致树分裂效率很低,而 CatBoost 直接使用原始的类别列即可。(CatBoost 默认只对类别数不超过 one_hot_max_size 的特征做 One-Hot,CPU 上默认值一般为 2。)LightGBM 和 XGBoost 的原生类别支持也可以避免 One-Hot 膨胀,但高基数时更容易过拟合,需要配合 cat_smooth、max_cat_threshold 等参数。
节点 O:自定义目标函数
XGBoost 提供了最灵活的自定义目标函数接口,用户只需定义一阶梯度 $g_i$ 和二阶 Hessian $h_i$ 即可。这在需要优化非标准业务指标(如 Focal Loss 处理类别不平衡、Huber Loss 处理回归异常值、自定义排序损失)时非常有价值。LightGBM(sklearn 接口传入可调用对象 objective,原生接口 4.0 起在 params['objective'] 中传入可调用对象)和 CatBoost(实现 calc_ders_range 的 Python 类)也支持自定义目标,但 XGBoost 的自定义目标教程和社区示例最为丰富。
9.3 各算法适用场景详解
AdaBoost 适用场景
AdaBoost 最适合作为教学工具和快速基线(quick baseline)。其算法逻辑清晰,每轮迭代直观地展示"关注错分样本"的机制,非常适合教学演示和原理理解。在实际项目中,AdaBoost 在以下场景仍有价值:
- 数据规模极小($< 1000$ 样本)且特征维度低($< 20$)的二分类问题
- 需要快速验证数据质量:用默认参数的 AdaBoost 快速跑通端到端流程,确认数据加载和标签正确性
- 特征重要性初筛:AdaBoost 的
feature_importances_是各基学习器不纯度重要性按权重的加权平均,可以快速识别较重要的特征;但基于不纯度的重要性偏向高基数特征,严肃分析时应配合置换重要性(见 11.5 节) - 与理论教材对照:当需要复现 ESL 或教材中的算法实验时,sklearn 的 AdaBoost 是最直接的实现
AdaBoost 的局限在于:指数损失对误标注样本和离群点敏感(这些样本会被反复加权)、各轮难以并行、缺少对缺失值和类别特征的原生支持,在大多数任务上的精度也不如现代梯度提升实现。在大多数生产环境中,AdaBoost 已被梯度提升方法取代。
sklearn GBM 适用场景
sklearn 的 GradientBoostingClassifier/GradientBoostingRegressor 是经典 Gradient Boosting 的忠实实现,适合以下场景:
- 需要与 sklearn 生态深度集成:如使用 sklearn 的
Pipeline、GridSearchCV、cross_val_score等工具,且不希望引入外部依赖(XGBoost、LightGBM、CatBoost 均为第三方库) - 需要完全理解 GBM 的内部机制:sklearn 的 Python/Cython 代码比 XGBoost 的 C++ 核心更易读,适合源码学习和算法研究
- 中小规模数据($< 100,000$ 样本),且对训练速度不敏感
- 需要特定损失函数:如
Huber Loss(鲁棒回归)、Quantile Loss(分位数预测),sklearn GBM 原生支持且 API 稳定
sklearn GBM 的主要缺点是训练速度较慢(精确贪心分裂、单线程、无 GPU 支持),且不支持缺失值。(旧版本中的 presort 预排序参数已在 0.22 弃用、0.24 移除。)HistGradientBoostingClassifier/HistGradientBoostingRegressor 在 0.21 版以实验特性引入、1.0 版转为稳定,基于直方图并支持多线程、缺失值和类别特征,速度显著提升,可作为 sklearn 内部的首选替代方案;上面列出的 Huber、分位数损失它也支持(loss='quantile';Huber 需用经典 GBM)。
XGBoost 适用场景
XGBoost 是表格数据竞赛的常青树,适用于几乎所有结构化数据建模任务:
- 竞赛和基准测试:Kaggle、天池等竞赛中,XGBoost 通常是第一个尝试的算法,也是最终模型集成的核心组件
- 大规模数据(百万级样本):直方图近似、Block 结构、核外计算使其能处理超出内存的数据
- 需要自定义目标函数和评估指标:如金融风控中的自定义排序损失、医疗预测中的加权对数损失
- 需要模型可解释性:XGBoost 内置 TreeSHAP(
predict(..., pred_contribs=True),也可pred_interactions=True求交互值),并能配合 SHAP 库绘制全局重要性、个体解释、依赖图等(LightGBM 的pred_contrib=True与 CatBoost 的get_feature_importance(type='ShapValues')也提供同类能力) - 缺失值较多的数据:稀疏感知分裂自动学习最优方向,无需预处理猜测填充策略
- 分布式训练需求:XGBoost 支持 Dask、Spark、Ray 等分布式框架,适合企业级大数据平台
XGBoost 2.0 引入了多项改进:统一的 device 参数(GPU 训练写作 device='cuda',gpu_hist 写法随之弃用)、hist 成为默认树方法、实验性的多输出树(multi_strategy='multi_output_tree')、分位数回归目标 reg:quantileerror,以及重写的排序学习(learning-to-rank)实现。
LightGBM 适用场景
LightGBM 是大规模数据和高维特征场景的首选,特别适用于:
- 超大规模数据(千万级以上样本):直方图、Leaf-wise 生长和 EFB 特征捆绑通常使训练很快;还可通过
data_sample_strategy='goss'开启 GOSS 采样进一步加速(具体快慢与 XGBoosthist的差距取决于数据,应实测) - 高维稀疏特征(如广告 CTR 预测中的用户-商品交叉特征、文本特征):EFB 把互斥的稀疏特征捆绑在一起,显著减少有效特征数
- 内存极度受限:如 Kaggle Notebook 的有限内存环境、边缘设备部署
- 实时训练需求:如在线广告系统的实时模型更新,需要分钟级完成训练
- 类别特征已被 Label 编码:虽然原生支持不如 CatBoost 优雅,但显式声明
categorical_feature后效果良好
LightGBM 的 Leaf-wise 生长策略使其在相同 num_leaves 下比 XGBoost 的 Level-wise 策略构建更深的树,拟合能力更强,但也更容易过拟合。因此官方调参文档把 num_leaves 列为控制复杂度的主要参数,并建议配合 min_data_in_leaf,必要时再用 max_depth 限制树深。LightGBM 4.0 移除了 train()、cv() 和 sklearn fit() 中的 early_stopping_rounds 参数(改用 lgb.early_stopping() 回调),新增 data_sample_strategy 参数,并让 Linux 的 manylinux wheel 内置 OpenCL GPU 支持(pip install lightgbm 后传入 device='gpu' 即可)。
CatBoost 适用场景
CatBoost 以其开箱即用性和类别特征处理能力独树一帜,适合:
- 大量类别特征的数据:如电商(用户 ID、商品 ID、品牌、类目)、金融(交易类型、商户类别码 MCC)、医疗(诊断编码 ICD)
- 即插即用,减少调参时间:当项目周期紧张,没有充裕时间进行大量网格搜索时,CatBoost 的默认参数通常已能产生竞争力强的结果
- 需要降低目标泄漏风险:类别特征的有序目标统计(Ordered TS)避免了目标编码的泄漏;Ordered Boosting 进一步缓解梯度估计中的预测偏移(prediction shift),但在 CPU 上默认不启用(默认
boosting_type='Plain'),小数据集上可显式设置boosting_type='Ordered' - 需要结构规整的树:对称树(Oblivious Trees)在同一层的所有节点使用相同的分裂条件,结构规整,正则化效果较强,预测也很快
- 需要快速部署:CatBoost 的模型格式紧凑,C++ 推理库性能优异,适合生产环境低延迟部署
CatBoost 除类别特征外,还原生支持文本特征(text_features)和嵌入向量特征(embedding_features),并提供 grid_search/randomized_search 方法做简单的超参数搜索。当类别特征(尤其是高基数类别特征)在数据中占主要地位时,CatBoost 通常值得优先尝试。
9.4 最新版本特性对比
截至 2026 年 11 月,本书代码测试使用的版本为 scikit-learn 1.9.1、XGBoost 3.4.1、LightGBM 4.7.0、CatBoost 1.2.10。下表列出近几个大版本中对实践影响较大的变化(以各库官方 changelog 为准)。
| 库 | 版本 | 关键新特性 | 对实践的影响 |
|---|---|---|---|
| scikit-learn | 1.0 / 1.4 / 1.6 / 1.8 | 1.0:HistGradientBoosting 转为稳定;1.4:AdaBoostClassifier 的 algorithm='SAMME.R' 弃用,HistGradientBoosting 新增 categorical_features='from_dtype';1.6:移除 SAMME.R,algorithm 参数本身弃用,'from_dtype' 成为默认值;1.8:移除 algorithm 参数 | 新代码中不要再给 AdaBoostClassifier 传 algorithm;需要经典 GBM 的高速替代时优先考虑 HistGradientBoosting |
| XGBoost | 2.0 / 3.x | 2.0:新增 device 参数统一 CPU/GPU(gpu_hist 弃用)、hist 成为默认树方法、实验性多输出树 multi_strategy、reg:quantileerror;early_stopping_rounds 从 fit() 移到构造函数(1.6 弃用,2.1 移除旧写法);3.0:不再支持保存旧的二进制模型格式(3.1 起也不能加载) | GPU 训练写 device='cuda';模型用 .json 或 .ubj 保存(见 11.4 节) |
| LightGBM | 4.0 / 4.x | 4.0:移除 early_stopping_rounds、verbose_eval 等旧参数(改用回调),新增 data_sample_strategy(GOSS 改写为 data_sample_strategy='goss'),重写 CUDA 版本(device_type='cuda'),Linux wheel 内置 OpenCL GPU 支持;4.7:sklearn 接口的 fit() 新增 eval_X/eval_y 并弃用 eval_set | 早停统一用 lgb.early_stopping() 回调;GOSS 不要再写 boosting='goss' |
| CatBoost | 1.2.x | 1.2 系列持续改进 GPU 训练和新版本 Python/NumPy 兼容;默认 boosting_type 在 CPU 上为 'Plain',CPU 非多分类任务默认 bootstrap_type='MVS'(bagging_temperature 仅在 'Bayesian' 下生效) | 小数据集可显式尝试 boosting_type='Ordered';采样强度调 subsample 而非 bagging_temperature |
版本选择建议
- 新项目:优先使用 XGBoost 2.0+ 或 LightGBM 4.0+,两者在速度、功能和稳定性上均处于成熟阶段。若数据含有大量类别特征,选择 CatBoost 1.2+。
- 维护旧项目:升级到 sklearn 1.8+ 前,删除
AdaBoostClassifier(algorithm=...)参数,否则会报TypeError;升级 XGBoost/LightGBM 时检查fit()中的early_stopping_rounds等旧参数。考虑将GradientBoosting迁移到HistGradientBoosting以获得速度提升。 - 生产环境:三个库都提供 C/C++ 推理接口和 ONNX 等导出途径,XGBoost 和 LightGBM 的部署文档与社区资料最丰富;CatBoost 的对称树预测快,适合延迟敏感场景(如实时推荐)。
- 学术研究:若研究涉及算法变体或自定义损失,XGBoost 的接口灵活性和代码可扩展性最佳。
9.5 Boosting 与随机森林、深度学习的选择
上面的比较都在 Boosting 家族内部进行。实际项目中还常需要回答:要不要用随机森林或神经网络?
与随机森林(Bagging)相比:随机森林并行训练相互独立的深树,主要降低方差;Boosting 串行地拟合残差(负梯度),主要降低偏差(见第 1 章)。随机森林对超参数不敏感,几乎不会因为树多而过拟合,训练天然可并行,常被用作稳健的基线;调参充分的梯度提升在多数表格数据任务上精度更高,但对学习率、树数和树复杂度更敏感,需要早停。训练集很小、噪声很大或几乎没有调参时间时,随机森林往往是更省心的选择。
与深度学习相比:在中等规模(约一万到数万样本)的典型表格数据上,多项基准研究发现调参后的树集成模型(XGBoost、随机森林等)通常仍优于专门为表格数据设计的深度模型,而且训练成本低得多。Grinsztajn 等人(NeurIPS 2022)把原因归结为三点:神经网络偏向过于平滑的解,难以拟合不规则函数;对无信息特征不够鲁棒;对旋转不变,而表格数据的特征各有含义。Shwartz-Ziv 与 Armon(2022)也发现 XGBoost 在多数数据集上优于几种深度表格模型,而把两者集成通常最好。深度学习的优势在于图像、文本、音频等非结构化数据,以及需要端到端学习表示、多模态融合或超大规模数据持续训练的场景。
| 场景 | 推荐做法 |
|---|---|
| 结构化表格数据,样本数在百万以内 | 优先尝试 LightGBM / XGBoost / CatBoost,随机森林作为基线 |
| 几乎没有调参时间,或数据极小、噪声很大 | 随机森林或 CatBoost 默认参数 |
| 图像、文本、语音等非结构化数据 | 深度学习(可把网络提取的嵌入作为特征再接 GBDT) |
| 表格数据中混有长文本或图像字段 | 先用预训练模型提取嵌入,再与表格特征一起输入 GBDT;或训练多模态网络 |
| 追求竞赛级极致精度 | 多个 GBDT 与神经网络模型的集成(Stacking / 加权平均,见第 1 章) |